第一章:多源信息融合的基本概念

信息融合的定义

信息融合就是一种多层次、多方面的处理过程,包括对多源数据进行检测、相关、组合和估计,从而提高状态估计和身份估计的精度,以及对战场态势和威胁的重要程度进行适时完整的评价。

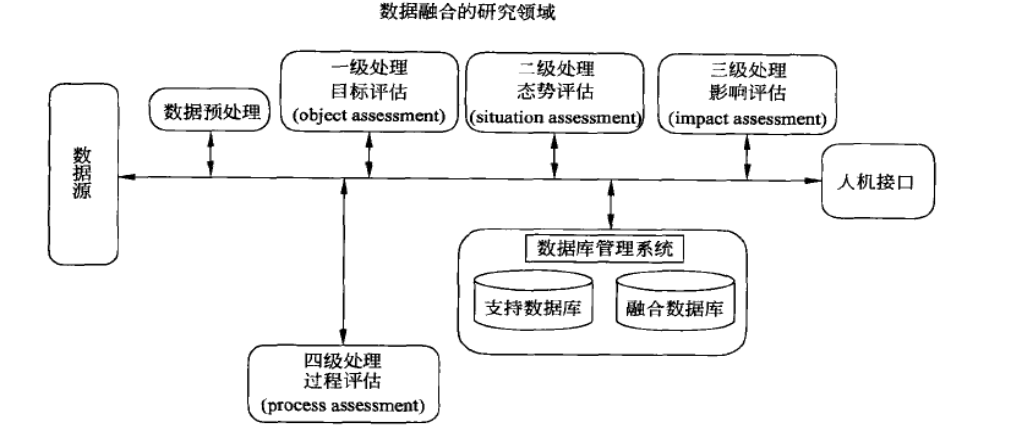
JDL数据融合模型
JDL

在JDL数据融合模型中,包括以下几种处理过程:

  • 第一级处理:目标评估
  • 第二级处理:态势评估
  • 第三级处理:影响评估
  • 第四级处理:过程评估

信息融合的级别

按照融合系统中的数据抽象层次,融合可划分位三个级别:数据级融合、特征级融合、决策级融合

  • 特征级融合:参量模板法、特征压缩、聚类方法、人工神经网络、K阶最近邻法
  • 决策级融合:Bayes推断、专家系统、D-S证据推理、模糊集理论

通用处理结构

  • 集中式结构
  • 分布式结构
  • 混合式结构

按融合技术分类

  • 假设检验型信息融合
  • 滤波跟踪型信息融合
  • 聚类分析型信息融合
  • 模式识别型信息融合
  • 人工智能型信息融合

按信息融合的目的分类

  • 检测融合
  • 估计融合
  • 属性融合

应用领域

  • 人工智能机器人
  • 智能交通系统
  • 汽车控制
  • 图像融合、检测与处理
  • 遥感遥测
  • 入侵检测

第二章:量测和观测方程

窄带随机噪声

如果噪声n(t)n(t)的功率谱密度Pn(ω)P_ n(\omega)在频率f=f0f=f_ 0和f=−f0f=-f_ 0附近一个很窄的频率范围内存在,而频率f0f_ 0相当高,则通常把这种高频限带噪声称为窄带噪声:

n(t)=an(t)cos⁡[ω0t+θn(t)]=nR(t)cos⁡ω0t−nI(t)sin⁡ω0tn(t)=a_n(t)\cos[\omega_ 0t+\theta_n(t)]=n_R(t)\cos\omega_0t-n_I(t)\sin\omega_0t

设噪声n(t)n(t)是均值为0,方差为σ2\sigma^2的平稳高斯随机过程,可以推得正交随机分量nR(t)n_ R(t)和nI(t)n_ I(t)也是均值为0,方差为σ2\sigma^2的高斯噪声,而且两者是不相关的。

于是,nR(t)n_ R(t)和nI(t)n_ I(t)的联合概率密度函数(隐去时间变量t后)为:

p(nR,nI)=12πσn2exp⁡(−nR2+nI22σn2)p(n_R,n_I)=\frac{1}{2\pi\sigma_n^2}\exp\left(-\frac{n_R^2+n_I^2}{2\sigma_n^2}\right)

最后可求得噪声的包络an(t)a_ n(t)、相位θn(t)\theta_ n(t)的概率密度函数,由包络an(t)a_ n(t)、相位θn(t)\theta_ n(t)与nR(t)n_ R(t)和nI(t)n_ I(t)的关系,利用二维雅克比变换,可得隐去时间变量的包络an(t)a_ n(t)、相位θn(t)\theta_ n(t)的联合概率密度函数。

p(an,θn)=an2πσn2exp⁡(−an22σn2)an≥0,−π≤θn≤πp(a_n,\theta_n)=\frac{a_n}{2\pi\sigma_n^2}\exp\left(-\frac{a_n^2}{2\sigma_n^2}\right)\qquad a_n\geq0, -\pi\leq\theta_n\leq\pi

噪声的包络an(t)a_ n(t)和相位θn(t)\theta_ n(t)的密度函数:

相位的包络为瑞利分布:

p(an)={anσn2exp⁡(−an22σn2),an≥00,an≤0p(a_n)= \begin{cases} \frac{a_n}{\sigma_n^{2}} \exp\left(-\frac{a_n^{2}}{2\sigma_n^{2}}\right), & a_n \ge 0 \\ 0, & a_n \le 0 \end{cases}

相位为均匀分布:

p(θn)={12π,−π≤θn≤π0,othersp\left( \theta _n \right) =\left\{ \begin{array}{c} \frac{1}{2\pi}, -\pi \le \theta _n\le \pi\\ 0, others\\ \end{array} \right.

WSN的三维多点定位

传感器观测信号是到达时间tit_ i或到达时间差Δti\Delta t_ i

融合处理的状态参数是特定目标的位置

(x−x1)2+(y−y1)2+(z−z1)2=r12=(Ct1)2\left( x-x_1 \right) ^2+\left( y-y_1 \right) ^2+\left( z-z_1 \right) ^2={r_1}^2=\left( Ct_1 \right) ^2

(x−x2)2+(y−y2)2+(z−z2)2=r22=(Ct2)2\left( x-x_2 \right) ^2+\left( y-y_2 \right) ^2+\left( z-z_2 \right) ^2={r_2}^2=\left( Ct_2 \right) ^2

⋯\cdots

(x−xn)2+(y−yn)2+(z−zn)2=rn2=(Ctn)2\left( x-x_n \right) ^2+\left( y-y_n \right) ^2+\left( z-z_n \right) ^2={r_n}^2=\left( Ct_n \right) ^2

多点定位法的量测模型:

ΔT=f(X)+WΔT=(Δti)T,W=(wi)T,wi∼N(0,σi2)  \Delta T=f\left( X \right) +W \\ \Delta T=\left( \Delta t_i \right) ^T, W=\left( w_i \right) ^T, w_i\sim N\left( 0,\sigma _{i}^{2} \right) \,\,

量测建模

量测建模的概念:在进行目标信息的检测、估计以及目标信息融合处理需要建立观测方程,也称为量测方程:

Z:观测信号=f(X:状态变量)+g(W:观测噪声)Z:\text{观测信号}=f\left( X:\text{状态变量} \right) +g\left( W:\text{观测噪声} \right)

一般状态变量XX是目标的位置坐标,或位置信息加上速度信息:

X=(x,y,z)TX=(x,y,z,vx,vy,vz)T=(x,y,z,x˙,y˙,z˙)TX=\left( x,y,z \right) ^T \\ X=\left( x,y,z,v_x,v_y,v_z \right) ^T=\left( x,y,z,\dot{x},\dot{y},\dot{z} \right) ^T

以传感器坐标系的观测信号,对于雷达系统观测信号是方位角、仰角、距离,或包括多普勒频率计算的距离变化率:

X=(x,y,z)TX=(x,y,z,vx,vy,vz)T=(x,y,z,x˙,y˙,z˙)TX=\left( x,y,z \right) ^T \\ X=\left( x,y,z,v_x,v_y,v_z \right) ^T=\left( x,y,z,\dot{x},\dot{y},\dot{z} \right) ^T

建立雷达系统的观测方程:

z=h(x)+w\boldsymbol{z}=h\left( \boldsymbol{x} \right) +\boldsymbol{w}

z=(θ^i,η^i,r^i,r˙^i)T\boldsymbol{z}=\left( \hat{\theta}_i,\hat{\eta}_i,\hat{r}_i,\hat{\dot{r}}_i \right) ^T

θ^i=θi+wθ=arctan⁡(y/x)+wθ\hat{\theta}_i=\theta _i+w_{\theta}=\mathrm{arc}\tan \left( y/x \right) +w_{\theta}

η^i=ηi+wη=arctan⁡(z/x2+y2)+wη\hat{\eta}_i=\eta _i+w_{\eta}=\mathrm{arc}\tan \left( z/\sqrt{x^2+y^2} \right) +w_{\eta}

r^i=ri+wr=x2+y2+z2+wr\hat{r}_i=r_i+w_r=\sqrt{x^2+y^2+z^2}+w_r

r˙^i=r˙i+ωr˙=(xx˙+yy˙+zz˙)/x2+y2+z2+wr˙\hat{\dot{r}}_i=\dot{r}_i+\omega _{\dot{r}}=\left( x\dot{x}+y\dot{y}+z\dot{z} \right) /\sqrt{x^2+y^2+z^2}+w_{\dot{r}}


第三章:多源检测融合概念

多源检测融合概念

二元假设检验问题有两种可能的错误:

  1. H0H_ 0为真,判决u=1u=1为第一类错误,即虚警
  2. H1H_ 1为真,判决u=0u=0为第二类错误,即漏检

检测概率:Pd=P(u=1∣H1)=1−Pm\text{检测概率:}P_d=P\left( u=1|H_1 \right) =1-P_m

虚警概率:Pf=P(u=1∣H0)\text{虚警概率:}P_f=P\left( u=1|H_0 \right)

漏检概率:Pm=P(u=0∣H1)\text{漏检概率:}P_m=P\left( u=0|H_1 \right)

对于二元假设检验问题,数据集空间可划分为两个区域:R0R_ 0和R1R_ 1,如果数据点yy位于R0R_ 0区,则认为假设H0H_ 0成立而做出决策u=0u=0. 反之若数据点yy位于R1R_ 1区,则认为假设H1H_ 1成立而作出决策u=1u=1.

假设p0(z)p_ 0(z)和p1(z)p_ 1(z)分别为关于H0H_ 0和H1H_ 1的条件概率密度,下图中斜线部分①和②表示了第一类错误概率:虚警概率PfP_ f和第二类错误概率:漏检概率PmP_ m, 虚线是判决门限。

多元检测融合策略

”与“融合检测准则

u0={0,存在判决为0的传感器1,所有传感器判决为1u_0=\left\{ \begin{array}{c} 0, \text{存在判决为}0\text{的传感器}\\ 1\text{,} \text{所有传感器判决为}1\\ \end{array} \right.

经过”与“融合检测后,系统的检测概率PdP_ d和虚警概率PfP_ f分别为:

Pd=∏i=1NPdiPf=∏i=1NPfiP_d=\prod_{i=1}^N{P_{d}^{i}}\qquad P_f=\prod_{i=1}^N{P_{f}^{i}}

这种融合策略可以大大降低系统的虚警概率,但是也会大大降低系统的检测概率。

”或“融合检测准则

u0={0,所有传感器判决为01,存在判决为1的传感器u_0=\left\{ \begin{array}{c} 0, \text{所有传感器判决为}0\\ 1\text{,} \text{存在判决为}1\text{的传感器}\\ \end{array} \right.

很容易证明,经过”或“融合检测后,系统的检测概率PdP_ d和虚警概率PfP_ f分别为:

Pd=1−∏i=1N(1−Pdi)Pf=1−∏i=1N(1−Pfi)P_d=1-\prod_{i=1}^N{\left( 1-P_{d}^{i} \right)}\qquad P_f=1-\prod_{i=1}^N{\left( 1-P_{f}^{i} \right)}

这种融合策略可以大大提高检测概率,但是也会大大增加系统的虚警概率。

表决融合检测准则(k/n准则)

u0={0,所有传感器中判决为1的个数少于k1,所有传感器中判决为1的个数大于等于ku_0=\left\{ \begin{array}{c} 0, \text{所有传感器中判决为}1\text{的个数少于}k\\ 1\text{,} \text{所有传感器中判决为}1\text{的个数大于等于}k\\ \end{array} \right.

这种融合策略是一种折衷处理。

基于似然函数比的融合检测准则

统计分析中的似然函数:是指在某种非随机参数的条件下观测到各种数据uu的概率,似然函数就是条件先验概率密度函数p(u∣Hi)p(u|H_ i)

多元检测中:在某种假设下各种判定输出的概率函数为似然函数,即p(u∣Hi)p(u|H_ i)

通常在确定检测规则后就确定了似然函数

先验概率:p(Hi)  后验概率:p(Hi∣u)似然函数:p(u∣Hi)\text{先验概率:}p\left( H_i \right) \,\,\qquad \text{后验概率:}p\left( H_i|u \right) \qquad \text{似然函数:}p\left( u|H_i \right)

似然函数比检测就是根据似然函数比是否超出门限进行决策,而最大似然函数估计就是求取使似然函数最大的一个参数作为参数估计。

基于似然函数比的多源融合检测准则有:

  1. 最大后验概率融合检测准则
  2. 贝叶斯融合检测准则
  3. 最下误差概率准则
最大后验概率融合检验准则

最大后验概率准则是根据已有的检测数据,分析给定全局决策值uu下各种假设(可能)的概率,选择最有可能产生该全局决策值的假设

令P(Hi∣u)P(H_ i|u)表示在给定全局决策值uu的前提下,HiH_ i为真的概率,则取对应于max⁡P(Hi∣u)\max P(H_ i|u)的一个假设HiH_ i

在而原假设目标检测中就是取两个概率中较大者所对应的假设。即若P(Hi∣u)>P(H0∣u)P(H_ i|u)>P(H_ 0|u),则选择H1H_ 1,反之选择H0H_ 0

上述规则可写为:

P(H1∣u)P(H0∣u)>1?H1:H0\frac{P\left( H_1|u \right)}{P\left( H_0|u \right)}>1 ? H_1:H_0

应用贝叶斯法则得到:

P(H1∣u)P(H0∣u)=P(u∣H1)P(H1)P(u∣H0)P(H0)\frac{P\left( H_1|u \right)}{P\left( H_0|u \right)}=\frac{P\left( u|H_1 \right) P\left( H_1 \right)}{P\left( u|H_0 \right) P\left( H_0 \right)}

⇒似然比λ(u)=P(u∣H1)P(u∣H0)>P(H0)P(H1)  ?H1:H0\Rightarrow \text{似然比}\lambda \left( u \right) =\frac{P\left( u|H_1 \right)}{P\left( u|H_0 \right)}>\frac{P\left( H_0 \right)}{P\left( H_1 \right)}\,\,? H_1:H_0

N个传感器的最大后验概率融合检测

最大后验概率检测准则是选择似然函数比大于P0/P1P_ 0/P_ 1的数据为R1R_ 1数据空间进行检测

λ(u)=P(u∣H1)P(u∣H0)=∏R1P(ui=1∣H1)∏R0P(ui=0∣H1)∏R1P(ui=1∣H0)∏R0P(ui=0∣H0)u=(u1,u2,⋯ ,uN)\lambda \left( u \right) =\frac{P\left( u|H_1 \right)}{P\left( u|H_0 \right)}=\frac{\prod_{R_1}{P\left( u_i=1|H_1 \right)}\prod_{R_0}{P\left( u_i=0|H_1 \right)}}{\prod_{R_1}{P\left( u_i=1|H_0 \right) \prod_{R_0}{P\left( u_i=0|H_0 \right)}}}\qquad u=\left( u_1,u_2,\cdots ,u_N \right)

根据P(ui=1∣H1)=Pdi=1−Pmi,P(ui=0∣H1)=Pmi,\text{根据}P\left( u_i=1|H_1 \right) =P_{d}^{i}=1-P_{m}^{i}, P\left( u_i=0|H_1 \right) =P_{m}^{i},

  P(ui=0∣H0)=1−Pfi,P(ui=1∣H0)=Pfi\,\, P\left( u_i=0|H_0 \right) =1-P_{f}^{i}, P\left( u_i=1|H_0 \right) =P_{f}^{i}

λ(u)=∏R1(1−Pmi)∏R0Pmi∏R1Pfi∏R0(1−Pfi)\lambda \left( u \right) =\frac{\prod_{R_1}{\left( 1-P_{m}^{i} \right)}\prod_{R_0}{P_{m}^{i}}}{\prod_{R_1}{P_{f}^{i}\prod_{R_0}{\left( 1-P_{f}^{i} \right)}}}

对似然函数求对数:

ln⁡λ(u)=∑R1ln⁡1−PmiPfi+∑R0ln⁡Pmi1−Pfi\ln \lambda \left( u \right) =\sum_{R_1}{\ln \frac{1-P_{m}^{i}}{P_{f}^{i}}+\sum_{R_0}{\ln \frac{P_{m}^{i}}{1-P_{f}^{i}}}}

⇒∑i=1Nwi>ln⁡P0P1  ?H1:H0其中wii=1,2,⋯ ,N={ln⁡1−PmiPfi,ui=1ln⁡Pmi1−Pfi,ui=0\Rightarrow \sum_{i=1}^N{w_i>\ln \frac{P_0}{P_1}\,\,? H_1:H_0\qquad \text{其中}\mathop {w_i} \limits_{i=1,2,\cdots ,N}=\left\{ \begin{array}{c} \ln \frac{1-P_{m}^{i}}{P_{f}^{i}}, u_i=1\\ \ln \frac{P_{m}^{i}}{1-P_{f}^{i}}, u_i=0\\ \end{array} \right.}

贝叶斯融合检测准则

以二元假设检验问题为例定义代价:

CijC_ {ij}为假设HjH_ j成立时作出uiu_ i决策的代价,且满足:Ci≠j,j>CjjC_ {i\neq j,j}>C_ {jj}, 平均总代价:

C=P0[C00P(u0∣H0)+C10P(u1∣H0)]+P1[C01P(u0∣H1)+C11P(u1∣H1)]C=P_0\left[ C_{00}P\left( u_0|H_0 \right) +C_{10}P\left( u_1|H_0 \right) \right] +P_1\left[ C_{01}P\left( u_0|H_1 \right) +C_{11}P\left( u_1|H_1 \right) \right]

=P0[C00(1−P(u1∣H0))+C10P(u1∣H0)]+P1[C01(1−P(u1∣H1))+C11P(u1∣H1)]=P_0\left[ C_{00}\left( 1-P\left( u_1|H_0 \right) \right) +C_{10}P\left( u_1|H_0 \right) \right] +P_1\left[ C_{01}\left( 1-P\left( u_1|H_1 \right) \right) +C_{11}P\left( u_1|H_1 \right) \right]

=P0C00+P1C01+P0(C10−C00)Pf−P1(C01−C11)Pd=P_0C_{00}+P_1C_{01}+P_0\left( C_{10}-C_{00} \right) P_f-P_1\left( C_{01}-C_{11} \right) P_d

=P0C00+P1C01+P0(C10−C00)∫R1p0(z)dz−P(1)(C01−C11)∫R1p1(z)dz=P_0C_{00}+P_1C_{01}+P_0\left( C_{10}-C_{00} \right) \int_{R_1}{p_0\left( z \right) \mathrm{d}z}-P\left( 1 \right) \left( C_{01}-C_{11} \right) \int_{R_1}{p_1\left( z \right) \mathrm{d}z}

=P0C00+P1C01+∫R1[P0(C10−C00)p0(z)−P1(C01−C11)p1(z)]dz=P_0C_{00}+P_1C_{01}+\int_{R_1}{\left[ P_0\left( C_{10}-C_{00} \right) p_0\left( z \right) -P_1\left( C_{01}-C_{11} \right) p_1\left( z \right) \right] \mathrm{d}z}

应选择区域R1R_ 1使平均总代价最小,即保证上式积分项小于0。

由此得到二元假设检测的贝叶斯检测准则:

p1(z)p0(z)>P0(C10−C00)P1(C01−C11)  ?H1:H0\frac{p_1\left( z \right)}{p_0\left( z \right)}>\frac{P_0\left( C_{10}-C_{00} \right)}{P_1\left( C_{01}-C_{11} \right)}\,\,? H_1:H_0

按贝叶斯准则与按最大后验概率准则得到的检测系统只是门限不同,而代价的选取满足C10−C00=C01−C11C_ {10}-C_ {00}=C_ {01}-C_ {11}时,最大后验概率准则就是贝叶斯判决准则的特例。

最小误差概率准则

在有一些应用场合,对两类错误没有什么特殊的区别,那么令所有误差的代价函数最小也是一个合理的准则,即令C00=C11=0,C01=C10=0C_ {00}=C_ {11}=0, C_ {01}=C_ {10}=0.那么代价函数表达式为:

C=P0P(u1∣H0)+P1P(u0∣H1)=PeC=P_0P\left( u_1|H_0 \right) +P_1P\left( u_0|H_1 \right) =P_e

这里PeP_ e为误差概率,使C最小的策略就是使误差概率PeP_ e最小

因此最小误差概率准则与最大后验概率准则完全相同,准则为:

p1(z)p0(z)=P0P1  ?H1:H0\frac{p_1\left( z \right)}{p_0\left( z \right)}=\frac{P_0}{P_1}\,\,? H_1:H_0

贝叶斯融合检测准则讨论
  • C10−C00C_ {10}-C_ {00}大,即虚警引起的损失大,门限应取大一些使虚警出现的可能性小一些;反之亦然
  • C01−C11C_ {01}-C_ {11}大,即漏警引起的损失大,门限应取小一些使漏警出现的可能性小一点,反之亦然。
  • 在各种先验概率及各种错误决策的代价已知的情况下,贝叶斯是最优的方法,但是如何获得所需的先验概率以及各种错误决策的代价是应用该方法的一个关键问题。

Neyman-Pearson融合检测准则

Neyman-Pearson融合准则的基本原则是在假定虚警概率不超过某个特定上限的前提下,使检测概率最大。也就是说通过选择观测数据zz空间的R1R_ 1区来解决以下问题

max⁡∫R1p1(z∣H1)dz\max \int_{R_1}{p_1\left( z|H_1 \right) \mathrm{d}z}

s.t.∫R1p0(z∣H0)dz≤Pf=αs.t.\int_{R_1}p_0{\left( z|H_0 \right) \mathrm{d}z}\le P_f=\alpha

max⁡F=max⁡{∫R1p1(z∣H1)dz−γ[∫R1p0(z∣H0)dz−α]}\max F=\max \left\{ \int_{R_1}{p_1\left( z|H_1 \right) \mathrm{d}z-\gamma \left[ \int_{R_1}{p_0\left( z|H_0 \right) \mathrm{d}z-\alpha} \right]} \right\}

Neyman-Pearson引理:对于二元假设检验问题,已知其密度p0(z∣H0)p_ 0(z|H_ 0)和p1(z∣H1)p_ 1(z|H_ 1)

那么对于虚警概率:

∫R1p0(z∣H0)dz≤Pf=α\int_{R_1}{p_0\left( z|H_0 \right) \mathrm{d}z\le P_f=\alpha}

具有最大检测概率的R1R_ 1可由似然比得到:

p1(z∣H1)p0(z∣H0)>γ  ?R1:R0\frac{p_1\left( z|H_1 \right)}{p_0\left( z|H_0 \right)}>\gamma \,\,? R_1:R_0

其中$\gamma 是是P_ f(=\alpha)的函数。如果的函数。如果P_ f=0,只有在,只有在p_ 0(z)=0才为才为R_ 1区,否则区,否则\gamma为为-\infty,所有数据区都为,所有数据区都为R_ 0$

Neyman-Pearson准则不需要各个假设的先验概率P(H0)、P(H1)P(H_ 0)、P(H_ 1)


第四章:参数估计理论基础

设x∈Rnx\in R^n是一种未知参数向量,量测zz是一个mm维的随机向量,而zz的一组容量为NN的样本是{z1,z2,⋯ ,zNz_ 1,z_ 2,\cdots,z_ N},设对它的统计量为:

x^(N)=φ(z1,z2,⋯ ,zN)\hat{x}^{(N)}=\varphi(z_1,z_2,\cdots,z_N)

称其为对xx的一个估计量,其中φ(⋅)\varphi(\cdot)称为统计规则或估计算法。

点估计就是参数估计,因此估计的参数值是实数域上的一个点。

参数估计的评估

无偏估计

对于估计量如果满足: E(x^(N))=xE(\hat{x}^{(N)})=x, 则称x^(N)\hat{x}^{(N)}是对参数xx的一个无偏估计。

如果估计量满足: lim⁡N→∞E(x^(N))=x\lim_ {N\to \infty}E(\hat{x}^{(N)})=x, 则称x^(N)\hat{x}^{(N)}是对参数xx的渐进无偏估计.

有效估计

对某一参数的无偏估计量往往不止一个,而且无偏性仅仅表明x^(N)\hat{x}^{(N)}所有可能取的值按概率平均等于xx,可能它取的值大部分与xx相差很大。为保证x^(N)\hat{x}^{(N)}的取值能集中于xx附近,要求X^(N)\hat{X}^{(N)}的方差越小越好。

Cramer-Rao下限

任意无偏估计量x^(N)\hat{x}^{(N)}的方差必定满足:

var[x^(N)]=E[(x−x^(N))2]≥−1E{∂2ln⁡[pdf(z∣x)]∂x2}var[\hat{x}^{(N)}]=E[(x-\hat{x}^{(N)})^2]\geq-\frac{1}{E\{\frac{\partial^2\ln[pdf(z|x)]}{\partial x^2}\}}

参数估计的主要方法

  • 如果未知参数是随机的,可以利用Bayes估计理论进行估计,前提是假定已知联合概率密度
  • 如果未知参数不是随机的,可以利用似然概率函数进行估计,称为似然估计方法
  • 如果联合概率函数或似然概率函数未知,但可以限定估计量是观测量测的线性函数,进行参数估计,称为线性最小均方估计,此时一般已知测量参数的一阶/二阶统计量特征
  • 基于最小二乘估计,使用最少的先验知识,只需要知道观测信号模型即可进行处理

Bayes估计理论

定义:首先假设未知参数xx与量测zz的联合pdf为:

p(x,z)=∏i=1Np(x,zi)=∏i=1Np(x)⋅p(zi∣x)p\left( x,z \right) =\prod_{i=1}^N{p\left( x,z_i \right) =\prod_{i=1}^N{p\left( x \right) \cdot p\left( z_i|x \right)}}

定义估计误差为x~=x^(N)−x\tilde{x}=\hat{x}^{\left( N \right)}-x

MMSE最小均方误差估计

x^MSE=∫−∞∞xp(x∣z)dx=E(p(x∣z))\hat{x}_{MSE}=\int_{-\infty}^{\infty}{xp\left( x|z \right) \mathrm{d}x=E\left( p\left( x|z \right) \right)}

=∫−∞∞xp(z∣x)p(x)dxp(z)=∫−∞∞xp(z∣x)p(x)dx∫−∞∞p(z∣x)p(x)dx=\frac{\int_{-\infty}^{\infty}{xp\left( z|x \right) p\left( x \right)}\mathrm{d}x}{p\left( z \right)}=\frac{\int_{-\infty}^{\infty}{xp\left( z|x \right) p\left( x \right) \mathrm{d}x}}{\int_{-\infty}^{\infty}{p\left( z|x \right) p\left( x \right) \mathrm{d}x}}

MAP最大后验估计

[p(x)∂p(z∣x)∂x+p(z∣x)∂p(x)∂x]∣x^=x^MAP=0\left. \left[ p\left( x \right) \frac{\partial p\left( z|x \right)}{\partial x}+p\left( z|x \right) \frac{\partial p\left( x \right)}{\partial x} \right] \right|_{\hat{x}=\hat{x}_{MAP}}=0

最大似然ML估计

给定参数xx时两侧信息的似然函数为:p((z1,z2,⋯ ,zN)∣x)p((z_ 1,z_ 2,\cdots,z_ N)|x)

极大似然函数ML参数估计可描述为:

x^ML=argmax⁡xp(z1,z2,⋯ ,zN∣x)\hat{x}_{ML}=\mathrm{arg}\max _xp\left( z_1,z_2,\cdots ,z_N|x \right)

下面以线性观测方程为例,设定观测方程为:

zi=∑j=1Mhijxj+vk  i=1,2,⋯ ,N  ⇒z=Hx+vz_i=\sum_{j=1}^M{h_{ij}x_j+v_k\,\, i=1,2,\cdots ,N\,\, \Rightarrow z=Hx+v}

其中假定观测空间噪声是高斯的,即vv是高斯噪声矢量,有:

p(v)=1(2π)N/2∣Gv∣1/2exp⁡(−12vTGv−1v)p\left( v \right) =\frac{1}{\left( 2\pi \right) ^{N/2}|G_v|^{1/2}}\exp \left( -\frac{1}{2}v^TG_{v}^{-1}v \right)

得到以xx为参数的随机量测矢量zz的似然函数:

p(z∣x)=1(2π)2/N∣Gv∣1/2exp⁡(−12(z−Hx)TGv−1(z−Hx))p\left( z|x \right) =\frac{1}{\left( 2\pi \right) ^{2/N}|G_v|^{1/2}}\exp \left( -\frac{1}{2}\left( z-Hx \right) ^TG_{v}^{-1}\left( z-Hx \right) \right)

∂ln⁡(p(z∣x))∂x∣x=x^ML=0⇒  ∂(z−Hx)TGv−1(z−Hx)∂x=0\left. \frac{\partial \ln \left( p\left( z|x \right) \right)}{\partial x} \right|_{x=\hat{x}_{ML}}=0 \Rightarrow \,\,\frac{\partial \left( z-Hx \right) ^TG_{v}^{-1}\left( z-Hx \right)}{\partial x}=0

求解似然函数最大得到最大似然估计:

x^ML=(HTGv−1H)−1HTGv−1z\hat{x}_{ML}=\left( H^TG_{v}^{-1}H \right) ^{-1}H^TG_{v}^{-1}z

高斯噪声条件下最大似然估计满足克拉美-罗界,是最小方差无偏估计。

最小二乘LS与WLS估计(最小二乘是WLS的特例和最小均方误差MMSE的特例)

定理:如果参数xx本身可以表示称为量测信息的线性函数: x=Hz+vx=Hz+v. 其中vv是零均值的随机向量,有加权最小二乘WLS估计为:

x^MLS=argmin⁡x^1N(z−hx^)TW(z−hx^)=(HTWH)−1HTWz\hat{x}^{MLS}=\mathrm{arg}\min _{\hat{x}}\frac{1}{N}\left( z-h\hat{x} \right) ^TW\left( z-h\hat{x} \right) =\left( H^TWH \right) ^{-1}H^TWz

其中WW为对称阵,称为加权矩阵,当W=IW=I时是最小二乘估计,假设Gv=cov(v)G_ v=cov(v)

PWLS=cov(x~)=cov{(HTWH)−1HTWv}P^{WLS}=cov\left( \tilde{x} \right) =cov\left\{ \left( H^TWH \right) ^{-1}H^TWv \right\}

=(HTWH)−1HTW⋅Gv⋅WH(HTWH)−1=\left( H^TWH \right) ^{-1}H^TW\cdot G_v\cdot WH\left( H^TWH \right) ^{-1}

可以计算最佳加权系数为:Wopt=Gv−1W_ {opt}=G_ v^{-1}, 可得线性最小二乘最佳加权估计为:

x^optWLS=(HTGv−1H)−1HTGv−1z\hat{x}_{opt}^{WLS}=\left( H^TG_{v}^{-1}H \right) ^{-1}H^TG_{v}^{-1}z

PWLS=cov(x~)=(HTGv−1H)−1P^{WLS}=cov\left( \tilde{x} \right) =\left( H^TG_{v}^{-1}H \right) ^{-1}

最小二乘估计很易于实现,它不需要任何先验知识,只需要关于被估计量的观测信号模型,就能达到误差平方和最小

但最小二乘估计的估计量在特定情况下,如噪声均值为0,才能满足无偏或方差最小的特性

思考题

1.随机参量xx是通过另一个随机变量zz来观察。

已知:

p(z∣x)={xexp⁡(−xz),x≥0,z≥00,z<0p\left( z|x \right) =\left\{ \begin{array}{c} x\exp \left( -xz \right) , x\ge 0,z\ge 0\\ 0, z<0\\ \end{array} \right.

xx的先验概率函数(kk为常数)

p(x)={knΓ(n)xn−1exp⁡(−kx),x≥00,x<0p\left( x \right) =\left\{ \begin{array}{c} \frac{k^n}{\Gamma \left( n \right)}x^{n-1}\exp \left( -kx \right) , x\ge 0\\ 0, x<0\\ \end{array} \right.

计算随机参量xx的估计量和估计值方差:x^MSE,x^MAP,PMSE,PMAP\hat{x}_ {MSE},\hat{x}_ {MAP},P_ {MSE},P_ {MAP}

x^MSE=∫−∞∞xp(z∣x)p(x)dx∫−∞∞p(x)p(z∣x)dx\hat{x}_{MSE}=\frac{\int_{-\infty}^{\infty}{xp\left( z|x \right) p\left( x \right) \mathrm{d}x}}{\int_{-\infty}^{\infty}{p\left( x \right) p\left( z|x \right) \mathrm{d}x}}

=∫0∞knΓ(n)xn+1exp⁡(−(k+z)x)dx∫0∞knΓ(n)xnexp⁡(−(k+z)x)dx=∫0∞xn+1exp⁡(−(k+z)x)dx∫0∞xnexp⁡(−(k+z)x)dx=\frac{\int_0^{\infty}{\frac{k^n}{\varGamma \left( n \right)}x^{n+1}\exp \left( -\left( k+z \right) x \right) \mathrm{d}x}}{\int_0^{\infty}{\frac{k^n}{\varGamma \left( n \right)}x^n\exp \left( -\left( k+z \right) x \right) \mathrm{d}x}}=\frac{\int_0^{\infty}{x^{n+1}\exp \left( -\left( k+z \right) x \right) \mathrm{d}x}}{\int_0^{\infty}{x^n\exp \left( -\left( k+z \right) x \right) \mathrm{d}x}}

=1−(k+z)∫0∞xn+1dexp⁡(−(k+z)x)∫0∞xnexp⁡(−(k+z)x)dx=[1−(k+z)xn+1exp⁡(−(k+z)x)]x=0x=∞−(n+1)−(k+z)∫0∞xnexp⁡(−(k+z)x)dx∫0∞xnexp⁡(−(k+z)x)dx=\frac{\frac{1}{-\left( k+z \right)}\int_0^{\infty}{x^{n+1}\mathrm{d}\exp \left( -\left( k+z \right) x \right)}}{\int_0^{\infty}{x^n\exp \left( -\left( k+z \right) x \right) \mathrm{d}x}} =\frac{\left[ \frac{1}{-\left( k+z \right)}x^{n+1}\exp \left( -\left( k+z \right) x \right) \right] _{x=0}^{x=\infty}-\frac{\left( n+1 \right)}{-\left( k+z \right)}\int_0^{\infty}{x^n\exp \left( -\left( k+z \right) x \right) \mathrm{d}x}}{\int_0^{\infty}{x^n\exp \left( -\left( k+z \right) x \right) \mathrm{d}x}} \\

=n+1k+z=\frac{n+1}{k+z}

[p(z)∂p(z∣x)∂x+p(z∣x)∂p(z)∂x]∣x=x^MAP=0\left. \left[ p\left( z \right) \frac{\partial p\left( z|x \right)}{\partial x}+p\left( z|x \right) \frac{\partial p\left( z \right)}{\partial x} \right] \right|_{x=\hat{x}_{MAP}}=0

knΓ(n)xn−1exp⁡(−kx)(exp⁡(−xz)−zxexp⁡(−xz))+xexp⁡(−xz)knΓ(n)((n−1)xn−2exp⁡(−kx)−kxn−1exp⁡(−kx))=0\frac{k^n}{\varGamma \left( n \right)}x^{n-1}\exp \left( -kx \right) \left( \exp \left( -xz \right) -zx\exp \left( -xz \right) \right) +x\exp \left( -xz \right) \frac{k^n}{\varGamma \left( n \right)}\left( \left( n-1 \right) x^{n-2}\exp \left( -kx \right) -kx^{n-1}\exp \left( -kx \right) \right) =0

x^MAP=n+1z+k\hat{x}_{MAP}=\frac{n+1}{z+k}

PMAP=PMSE=E{x^MSE−E(x^MSE)}=0P_{MAP}=P_{MSE}=E\left\{ \hat{x}_{MSE}-E\left( \hat{x}_{MSE} \right) \right\} =0

2.单一参量xx的线性观测方程为:z=x+vz=x+v

其中zz是NN维观测矢量,vv是观测噪声:

v=(v1,⋯ ,vN),vi=N(0,σn2)v=\left( v_1,\cdots ,v_N \right) , v_i=N\left( 0,\sigma _{n}^{2} \right)

已知x∼N(0,σx2)x\sim N(0,\sigma_ x^2)

计算随机参量xx的Bayes估计值和估计值方差

p(z∣x)=1(2πσv2)N/2exp⁡(−∑i=1N(z−x)22σv2)p\left( z|x \right) =\frac{1}{\left( 2\pi \sigma _{v}^{2} \right) ^{N/2}}\exp \left( -\frac{\sum_{i=1}^N{\left( z-x \right) ^2}}{2\sigma _{v}^{2}} \right)

p(x)=1(2πσx2)1/2exp⁡(−x22σx2)p\left( x \right) =\frac{1}{\left( 2\pi \sigma _{x}^{2} \right) ^{1/2}}\exp \left( -\frac{x^2}{2\sigma _{x}^{2}} \right)

p(x∣z)=p(z∣x)p(x)p(z)=1p(z)1(2πσv2)N/2(2πσx2)1/2exp⁡(−∑i=1N(z−x)22σv2−x22σx2)p\left( x|z \right) =\frac{p\left( z|x \right) p\left( x \right)}{p\left( z \right)}=\frac{1}{p\left( z \right)}\frac{1}{\left( 2\pi \sigma _{v}^{2} \right) ^{N/2}\left( 2\pi \sigma _{x}^{2} \right) ^{1/2}}\exp \left( -\frac{\sum_{i=1}^N{\left( z-x \right) ^2}}{2\sigma _{v}^{2}}-\frac{x^2}{2\sigma _{x}^{2}} \right)

=1p(z)1(2πσv2)N/2(2πσx2)1/2exp⁡(−σx2∑i=1N(z2−2zx+x2)+σv2x22σv2σx2)=\frac{1}{p\left( z \right)}\frac{1}{\left( 2\pi \sigma _{v}^{2} \right) ^{N/2}\left( 2\pi \sigma _{x}^{2} \right) ^{1/2}}\exp \left( -\frac{\sigma _{x}^{2}\sum_{i=1}^N{\left( z^2-2zx+x^2 \right)}+\sigma _{v}^{2}x^2}{2\sigma _{v}^{2}\sigma _{x}^{2}} \right)

=1p(z)1(2πσv2)N/2(2πσx2)1/2exp⁡(−σx2∑i=1Nz2−σx2∑i=1N2zx+(σx2N+σv2)x22σv2σx2)=\frac{1}{p\left( z \right)}\frac{1}{\left( 2\pi \sigma _{v}^{2} \right) ^{N/2}\left( 2\pi \sigma _{x}^{2} \right) ^{1/2}}\exp \left( -\frac{\sigma _{x}^{2}\sum_{i=1}^N{z^2-\sigma _{x}^{2}\sum_{i=1}^N{2zx}+\left( \sigma _{x}^{2}N+\sigma _{v}^{2} \right) x^2}}{2\sigma _{v}^{2}\sigma _{x}^{2}} \right)

=1p(z)1(2πσv2)N/2(2πσx2)1/2exp⁡(−σx2∑i=1Nz2−(σx2∑i=1Nz)2(σx2N+σv2)2σv2σx2)exp⁡(−(x−σx2∑i=1Nz(σx2N+σv2))22σv2σx2(σx2N+σv2))=\frac{1}{p\left( z \right)}\frac{1}{\left( 2\pi \sigma _{v}^{2} \right) ^{N/2}\left( 2\pi \sigma _{x}^{2} \right) ^{1/2}}\exp \left( -\frac{\sigma _{x}^{2}\sum_{i=1}^N{z^2-\frac{\left( \sigma _{x}^{2}\sum_{i=1}^N{z} \right) ^2}{\left( \sigma _{x}^{2}N+\sigma _{v}^{2} \right)}}}{2\sigma _{v}^{2}\sigma _{x}^{2}} \right) \exp \left( -\frac{\left( x-\frac{\sigma _{x}^{2}\sum_{i=1}^N{z}}{\left( \sigma _{x}^{2}N+\sigma _{v}^{2} \right)} \right) ^2}{\frac{2\sigma _{v}^{2}\sigma _{x}^{2}}{\left( \sigma _{x}^{2}N+\sigma _{v}^{2} \right)}} \right)

=1p(z)K(z)exp⁡(−(x−σx2∑i=1Nz(σx2N+σv2))22σm2)=\frac{1}{p\left( z \right)}K\left( z \right) \exp \left( -\frac{\left( x-\frac{\sigma _{x}^{2}\sum_{i=1}^N{z}}{\left( \sigma _{x}^{2}N+\sigma _{v}^{2} \right)} \right) ^2}{2\sigma _{m}^{2}} \right)

K(z)=1(2πσv2)N/2(2πσx2)1/2exp⁡(−σx2∑i=1Nz2−(σx2∑i=1Nz)2(σx2N+σv2)2σv2σx2),σm2=σv2σx2(σx2N+σv2)K\left( z \right) =\frac{1}{\left( 2\pi \sigma _{v}^{2} \right) ^{N/2}\left( 2\pi \sigma _{x}^{2} \right) ^{1/2}}\exp \left( -\frac{\sigma _{x}^{2}\sum_{i=1}^N{z^2-\frac{\left( \sigma _{x}^{2}\sum_{i=1}^N{z} \right) ^2}{\left( \sigma _{x}^{2}N+\sigma _{v}^{2} \right)}}}{2\sigma _{v}^{2}\sigma _{x}^{2}} \right) , \sigma _{m}^{2}=\frac{\sigma _{v}^{2}\sigma _{x}^{2}}{\left( \sigma _{x}^{2}N+\sigma _{v}^{2} \right)}

Bayes估计值:

x^MSE=x^MAP=(σx2∑i=1Nz)2(σx2N+σv2),σm2=σv2σx2(σx2N+σv2)\hat{x}_{MSE}=\hat{x}_{MAP}=\frac{\left( \sigma _{x}^{2}\sum_{i=1}^N{z} \right) ^2}{\left( \sigma _{x}^{2}N+\sigma _{v}^{2} \right)}, \sigma _{m}^{2}=\frac{\sigma _{v}^{2}\sigma _{x}^{2}}{\left( \sigma _{x}^{2}N+\sigma _{v}^{2} \right)}

作业1:设总体XX的概率密度函数为

f(x;α)={αxα−1,0<x<10,otherwisef\left( x;\alpha \right) =\left\{ \begin{array}{c} \alpha x^{\alpha -1}, 0<x<1\\ 0, otherwise\\ \end{array} \right.

其中α>0\alpha>0为未知参数,x1,x2,⋯ ,xnx_ 1,x_ 2,\cdots,x_ n是一组样本值,求参数α\alpha的最大似然ML估计

f(x1,x2,⋯xn∣α)=αn(∏i=1nxi)α−1f\left( x_1,x_2,\cdots x_n|\alpha \right) =\alpha ^n\left( \prod_{i=1}^n{x_i} \right) ^{\alpha -1}

ln⁡f(x1,x2,⋯xn∣α)=nln⁡α+(α−1)∑i=1nln⁡(xi)\ln f\left( x_1,x_2,\cdots x_n|\alpha \right) =n\ln \alpha +\left( \alpha -1 \right) \sum_{i=1}^n{\ln \left( x_i \right)}

∂ln⁡f(x1,x2,⋯xn∣α)∂α=nα+∑i=1nln⁡(xi)=0\frac{\partial \ln f\left( x_1,x_2,\cdots x_n|\alpha \right)}{\partial \alpha}=\frac{n}{\alpha}+\sum_{i=1}^n{\ln \left( x_i \right)}=0

α=−n∑i=1nln⁡(xi)\alpha =-\frac{n}{\sum_{i=1}^n{\ln \left( x_i \right)}}

作业2:设总体X的概率密度函数为

f(x;a)={(α+1)xα−1,0<x<10,otherwisef\left( x;a \right) =\left\{ \begin{array}{c} \left( \alpha +1 \right) x^{\alpha -1}, 0<x<1\\ 0, otherwise\\ \end{array} \right.

其中α>0\alpha>0为未知参数,x1,x2,⋯ ,xnx_ 1,x_ 2,\cdots,x_ n是一组样本值,求参数α\alpha的最大似然ML估计

f(x1,x2,⋯xn∣α)=(α+1)n(∏i=1nxi)α−1f\left( x_1,x_2,\cdots x_n|\alpha \right) =\left( \alpha +1 \right) ^n\left( \prod_{i=1}^n{x_i} \right) ^{\alpha -1}

ln⁡f(x1,x2,⋯xn∣α)=nln⁡(α+1)+(α−1)∑i=1nln⁡(xi)\ln f\left( x_1,x_2,\cdots x_n|\alpha \right) =n\ln \left( \alpha +1 \right) +\left( \alpha -1 \right) \sum_{i=1}^n{\ln \left( x_i \right)}

∂ln⁡f(x1,x2,⋯xn∣α)∂α=nα+1+∑i=1nln⁡(xi)=0\frac{\partial \ln f\left( x_1,x_2,\cdots x_n|\alpha \right)}{\partial \alpha}=\frac{n}{\alpha +1}+\sum_{i=1}^n{\ln \left( x_i \right)}=0

α=−n∑i=1nln⁡(xi)−1\alpha =-\frac{n}{\sum_{i=1}^n{\ln \left( x_i \right)}}-1

作业3:已知一组量测信息zz与待估计状态xx的关系为:z=Hx+wz=Hx+w,请写出线性最小二乘(LS)指标,并给出批处理最小二乘的估计表达式(给出推导过程)。

x^LS=argmin⁡x^1N(z−Hx^)T(z−Hx^)\hat{x}^{LS}=\mathrm{arg}\min _{\hat{x}}\frac{1}{N}\left( z-H\hat{x} \right) ^T\left( z-H\hat{x} \right)

min⁡1N(z−Hx^)T(z−Hx^)=min⁡1N(zTz−zTHx^−x^THTz+x^THTHx^)\min \frac{1}{N}\left( z-H\hat{x} \right) ^T\left( z-H\hat{x} \right) =\min \frac{1}{N}\left( z^Tz-z^TH\hat{x}-\hat{x}^TH^Tz+\hat{x}^TH^TH\hat{x} \right)

∂1N(zTz−zTHx^−x^THTz+x^THTHx^)∂x^=0\frac{\partial \frac{1}{N}\left( z^Tz-z^TH\hat{x}-\hat{x}^TH^Tz+\hat{x}^TH^TH\hat{x} \right)}{\partial \hat{x}}=0

−2zTH+2x^THTH=0-2z^TH+2\hat{x}^TH^TH=0

x^T=zTH(HTH)−1\hat{x}^T=z^TH\left( H^TH \right) ^{-1}

x^=(HTH)−1HTz\hat{x}=\left( H^TH \right) ^{-1}H^Tz

作业4:假设空间中三个探测器对一目标进行定位,探测器坐标A(x1,y1)A(x_ 1,y_ 1),B(x2,y2)B(x_ 2,y_ 2),C(x3,y3)C(x_ 3,y_ 3),各探测器得目标相对距离分别为d1,d2,d3d_ 1,d_ 2,d_ 3,请用最小二乘方法给出目标的位置估计

(x1−x)2+(y1−y)2=d12\left( x_1-x \right) ^2+\left( y_1-y \right) ^2=d_{1}^{2}

(x2−x)2+(y2−y)2=d22\left( x_2-x \right) ^2+\left( y_2-y \right) ^2=d_{2}^{2}

(x3−x)2+(y3−y)2=d32\left( x_3-x \right) ^2+\left( y_3-y \right) ^2=d_{3}^{2}

x12−2x1x−x22+2x2x+y12−2y1y−y22+2y2y=d12−d22x_{1}^{2}-2x_1x-x_{2}^{2}+2x_2x+y_{1}^{2}-2y_1y-y_{2}^{2}+2y_2y=d_{1}^{2}-d_{2}^{2}

2(x2−x1)x+2(y2−y1)y=d12−d22−x12+x22−y12+y222\left( x_2-x_1 \right) x+2\left( y_2-y_1 \right) y=d_{1}^{2}-d_{2}^{2}-x_{1}^{2}+x_{2}^{2}-y_{1}^{2}+y_{2}^{2}

2(x3−x1)x+2(y3−y1)y=d12−d32−x12+x32−y12+y322\left( x_3-x_1 \right) x+2\left( y_3-y_1 \right) y=d_{1}^{2}-d_{3}^{2}-x_{1}^{2}+x_{3}^{2}-y_{1}^{2}+y_{3}^{2}

(2(x2−x1)2(y2−y1)2(x3−x1)2(y3−y1))(xy)=(d12−d22−x12+x22−y12+y22d12−d32−x12+x32−y12+y32)\left( \begin{matrix} 2\left( x_2-x_1 \right)& 2\left( y_2-y_1 \right)\\ 2\left( x_3-x_1 \right)& 2\left( y_3-y_1 \right)\\ \end{matrix} \right) \left( \begin{array}{c} x\\ y\\ \end{array} \right) =\left( \begin{array}{c} d_{1}^{2}-d_{2}^{2}-x_{1}^{2}+x_{2}^{2}-y_{1}^{2}+y_{2}^{2}\\ d_{1}^{2}-d_{3}^{2}-x_{1}^{2}+x_{3}^{2}-y_{1}^{2}+y_{3}^{2}\\ \end{array} \right) \\

A(xy)=BA\left( \begin{array}{c} x\\ y\\ \end{array} \right) =B

x=(HTH)−1HTz  ⇒x^=(ATA)−1ATBx=\left( H^TH \right) ^{-1}H^Tz\,\,\Rightarrow \hat{x}=\left( A^TA \right) ^{-1}A^TB


第五章:线性系统状态滤波理论

上一讲中参数估计是假定未知参数是一个随机向量或确定向量,比如具体的信号参数估计,白噪声中的通信信号,对未知参数的动态性和系统性能没有进行说明,实际上是进行了弱化和规避。

本讲中我们将推广到具体目标系统的参数估计,未知参数对应具体目标或系统的信号和特征,因此需要引入未知参数的随机动态特性描述:从只有观测方程->既有观测方程又有状态转移方程

离散时间线性随机动态系统描述

定义:离散时间线性随机动态系统:

状态方程:

xk+1=Fkxk+Γkwkx_{k+1}=F_kx_k+\varGamma _kw_k

量测方程:

zk=Hkxk+vkz_k=H_kx_k+v_k

其中:xkx_ k是kk时刻的系统状态向量,FkF_ k是系统状态转移矩阵,而wkw_ k是过程演化噪声,Γk\varGamma_ k是噪声矩阵,zkz_ k是kk时刻对系统的量测向量,HkH_ k是量测矩阵,而vkv_ k是量测噪声。

假定直到kk时刻所有的量测信息是:

zk=(z1,z2,⋯ ,zk)z^k=(z_1,z_2,\cdots,z_k)

  • 基于量测信息zkz^k,对xkx_ k的估计问题,称为状态滤波问题

  • 基于量测信息zkz^k,对xk+lx_ {k+l},l>0l>0的估计问题,称为状态预测问题

  • 基于量测信息zkz^k,对xk−lx_ {k-l},l>0l>0的估计问题,称为状态平滑问题

定义新息序列:

前面所描述的离散时间线性随机动态系统,假定所有随机变量都是高斯的情况下,考虑对于量测的一步提前预测:

z^k∣k−1=E(zk∣zk−1)=∫−∞∞zkp(zk∣z1,⋯ ,zk−1)dzk\hat{z}_{k|k-1}=E\left( z_k|z^{k-1} \right) =\int_{-\infty}^{\infty}{z_kp\left( z_k|z_1,\cdots ,z_{k-1} \right) \mathrm{d}z_k}

量测的提前一步预测是量测的期望

预测量测误差序列:z~k∣k−1=zk−z^k∣k−1\tilde{z}_ {k|k-1}=z_ k-\hat{z}_ {k|k-1}, 称为量测残差序列,又称为新息序列

定理:Gauss序列z1,z2,⋯ ,zk{z_ 1,z_ 2,\cdots,z_ k}所产生的信息序列z~1∣0,z~2∣1,⋯ ,z~k∣k−1\tilde{z}_ {1|0}, \tilde{z}_ {2|1}, \cdots , \tilde{z}_ {k|k-1}是一个零均值的独立过程,它与原量测序列之间存在因果性线性运算,而且包含了原序列的所有信息

新息的性质:
  • kk时刻的新息z~k∣k−1\tilde{z}_ {k|k-1}与过去所有的观测数据(z1,z2,⋯ ,zk)({z_ 1,z_ 2,\cdots,z_ k})正交
  • 新息过程由彼此正交的随机序列(z~1∣0,z~2∣1,⋯ ,z~k∣k−1)(\tilde{z}_ {1|0}, \tilde{z}_ {2|1}, \cdots , \tilde{z}_ {k|k-1})线性组成
  • 表示观测数据的随机向量序列(z1,z2,⋯ ,zk)({z_ 1,z_ 2,\cdots,z_ k})和表示新息过程的随机向量(z~1∣0,z~2∣1,⋯ ,z~k∣k−1)(\tilde{z}_ {1|0}, \tilde{z}_ {2|1}, \cdots , \tilde{z}_ {k|k-1})一一对应
  • 同时原量测序列、一步提前预测序列和信息序列构成一个一步提前预测器,这个预测器是一个具有单位反馈的线性系统。

假定所有随机变量都是Gauss的情况下:

线性系统:

xk+1=Fkxk+Γkwkx_{k+1}=F_kx_k+\varGamma _kw_k

z=Hkxk+vkz=H_kx_k+v_k

wk{w_ k}是独立过程:wk∼N(0,Qkw)w_ k\sim N(0,Q_ k^w), vk{v_ k}是独立过程:vk∼N(0,Qkv)v_ k \sim N(0,Q_ k^v) , 系统初始状态: x0∼N(xˉ0,P0)x_ 0\sim N(\bar{x}_ 0,P_ 0)

如果以上三个随机过程彼此独立,则对于任意损失函数可以使用基本Kalman滤波公式定理

基本Kalman滤波器

  • 初始条件:

    x^0∣0=xˉ0,x~0∣0=x0−x^0∣0,cov(x~0∣0)=P0\hat{x}_{0|0}=\bar{x}_0, \tilde{x}_{0|0}=x_0-\hat{x}_{0|0}, cov\left( \tilde{x}_{0|0} \right) =P_0

  • 状态时间更新:

    x^k∣k−1=Fk−1x^k−1∣k−1\hat{x}_{k|k-1}=F_{k-1}\hat{x}_{k-1|k-1}

  • 方差时间更新:

    Pk∣k−1=Fk−1Pk−1∣k−1Fk−1T+Γk−1Qk−1wΓk−1TP_{k|k-1}=F_{k-1}P_{k-1|k-1}F_{k-1}^{T}+\varGamma _{k-1}Q_{k-1}^{w}\varGamma _{k-1}^{T}

  • 计算Kalman增益:

    Kk=Pk∣k−1HkT(HkPk∣k−1HkT+Qkv)−1K_k=P_{k|k-1}H_{k}^{T}\left( H_kP_{k|k-1}H_{k}^{T}+Q_{k}^{v} \right) ^{-1}

  • 计算状态滤波更新:

    x^k∣k=x^k∣k−1+Kk(zk−Hkx^k∣k−1)\hat{x}_{k|k}=\hat{x}_{k|k-1}+K_k\left( z_k-H_k\hat{x}_{k|k-1} \right)

  • 计算方差滤波更新:

    Pk∣k=Pk∣k−1−KkHkPk∣k−1P_{k|k}=P_{k|k-1}-K_kH_kP_{k|k-1}

Kalman滤波器的应用

设有一系统对飞行器进行观测,飞行器状态参数为纵向距离、速度、加速度。假设飞行器对地面纵向作匀加速直线运动,假设未叠加飞行器扰动,且假设初始状态为

x=(r,v,a)TE(r0)=0,σr02=8(km)2E(v0)=0,σv02=10(km)2E(a0)=0.2km/s2,σa02=5(km)2x=\left( r,v,a \right) ^T \\ E\left( r_0 \right) =0, \sigma _{r_0}^{2}=8\left( \mathrm{km} \right) ^2 \\ E\left( v_0 \right) =0, \sigma _{v_0}^{2}=10\left( \mathrm{km} \right) ^2 \\ E\left( a_0 \right) =0.2\mathrm{km}/s^2, \sigma _{a_0}^{2}=5\left( \mathrm{km} \right) ^2

观测信号为距离,每2s进行一次观测,观测噪声为零均值的白噪声σn2=0.15(km)2\sigma_ n^2=0.15(\mathrm{km})^2

xk+1=Fkxk+Γwkx_{k+1}=F_kx_k+\varGamma w_k

zk=Hkxk+vkz_k=H_kx_k+v_k

x^k∣k−1=Fk−1x^k−1∣k−1\hat{x}_{k|k-1}=F_{k-1}\hat{x}_{k-1|k-1}

Pk∣k−1=Fk−1Pk−1∣k−1Fk−1T+Γk−1Qk−1wΓk−1TP_{k|k-1}=F_{k-1}P_{k-1|k-1}F_{k-1}^{T}+\varGamma _{k-1}Q_{k-1}^{w}\varGamma _{k-1}^{T}

Kk=Pk∣k−1HkT(HkPk∣k−1HkT+Qkv)−1K_k=P_{k|k-1}H_{k}^{T}\left( H_kP_{k|k-1}H_{k}^{T}+Q_{k}^{v} \right) ^{-1}

x^k∣k=x^k∣k−1+Kk(zk−Hkx^k∣k−1)\hat{x}_{k|k}=\hat{x}_{k|k-1}+K_k\left( z_k-H_k\hat{x}_{k|k-1} \right)

Pk∣k=Pk∣k−1−KkHkPk∣k−1P_{k|k}=P_{k|k-1}-K_kH_kP_{k|k-1}

Fk=[1TT2201T001]=[122012001],Γk=[000],Hk=[100]F_k=\left[ \begin{matrix} 1& T& \frac{T^2}{2}\\ 0& 1& T\\ 0& 0& 1\\ \end{matrix} \right] =\left[ \begin{matrix} 1& 2& 2\\ 0& 1& 2\\ 0& 0& 1\\ \end{matrix} \right] , \varGamma _k=\left[ \begin{matrix} 0& 0& 0\\ \end{matrix} \right] , H_k=\left[ \begin{matrix} 1& 0& 0\\ \end{matrix} \right] \\

x0=[000.2],P0∣0=(8000100005)x_0=\left[ \begin{matrix} 0& 0& 0.2\\ \end{matrix} \right] , P_{0|0}=\left( \begin{matrix} 8& 0& 0\\ 0& 10& 0\\ 0& 0& 5\\ \end{matrix} \right)

x^1∣0=[122012001][000.2]T=[0.40.40.2]T\hat{x}_{1|0}=\left[ \begin{matrix} 1& 2& 2\\ 0& 1& 2\\ 0& 0& 1\\ \end{matrix} \right] \left[ \begin{matrix} 0& 0& 0.2\\ \end{matrix} \right] ^T=\left[ \begin{matrix} 0.4& 0.4& 0.2\\ \end{matrix} \right] ^T

P1∣0=F0P0∣0F0T=[122012001][8000100005][122012001]T=[68401040301010105]P_{1|0}=F_0P_{0|0}F_{0}^{T}=\left[ \begin{matrix} 1& 2& 2\\ 0& 1& 2\\ 0& 0& 1\\ \end{matrix} \right] \left[ \begin{matrix} 8& 0& 0\\ 0& 10& 0\\ 0& 0& 5\\ \end{matrix} \right] \left[ \begin{matrix} 1& 2& 2\\ 0& 1& 2\\ 0& 0& 1\\ \end{matrix} \right] ^T=\left[ \begin{matrix} 68& 40& 10\\ 40& 30& 10\\ 10& 10& 5\\ \end{matrix} \right]

K1=168.15[684010]K_1=\frac{1}{68.15}\left[ \begin{array}{c} 68\\ 40\\ 10\\ \end{array} \right]

x^1∣1=x^1∣0+K1(z−H1x^1∣0)=[0.40.40.2]T−0.0468.15[684010]=[0.36000.37650.1941]T\hat{x}_{1|1}=\hat{x}_{1|0}+K_1\left( z-H_1\hat{x}_{1|0} \right) =\left[ \begin{matrix} 0.4& 0.4& 0.2\\ \end{matrix} \right] ^T-\frac{0.04}{68.15}\left[ \begin{array}{c} 68\\ 40\\ 10\\ \end{array} \right] =\left[ \begin{matrix} 0.3600& 0.3765& 0.1941\\ \end{matrix} \right] ^T

P1∣1=P1∣0−KkHkP1∣0=[68401040301010105]−168.15[684010][100][68401040301010105]=[0.14960.08800.0220.0886.52234.13050.0224.13053.5326]P_{1|1}=P_{1|0}-K_kH_kP_{1|0}=\left[ \begin{matrix} 68& 40& 10\\ 40& 30& 10\\ 10& 10& 5\\ \end{matrix} \right] -\frac{1}{68.15}\left[ \begin{array}{c} 68\\ 40\\ 10\\ \end{array} \right] \left[ \begin{matrix} 1& 0& 0\\ \end{matrix} \right] \left[ \begin{matrix} 68& 40& 10\\ 40& 30& 10\\ 10& 10& 5\\ \end{matrix} \right] =\left[ \begin{matrix} 0.1496& 0.0880& 0.022\\ 0.088& 6.5223& 4.1305\\ 0.022& 4.1305& 3.5326\\ \end{matrix} \right]

思考题

设系统的信号状态为xk=xk−1x_ k=x_ {k-1}, zk=xk+nkz_ k=x_ k+n_ k

初始状态x0x_ 0的统计特性为:

E(x0)=ux0,E[(x0−ux0)(x0−ux0)T]=Cx0E\left( x_0 \right) =u_{x_0}, E\left[ \left( x_0-u_{x_0} \right) \left( x_0-u_{x_0} \right) ^T \right] =C_{x_0} \\

观测噪声nkn_ k的统计特性为:

E(nk)=0,E(x0nk)=0,E[ninjT]=CnkδijE\left( n_k \right) =0, E\left( x_0n_k \right) =0, E\left[ n_in_{j}^{T} \right] =C_{n_k}\delta _{ij}

若取状态滤波的初始状态为:

x^0=ux0,P0=αI,α为常数\hat{x}_0=u_{x_0}, P_0=\alpha I, \alpha \text{为常数}

求状态滤波值x^1\hat{x}_ 1和状态滤波的均方误差矩阵P1P_ 1

xk=xk−1,zk=xk+nkx_k=x_{k-1}, z_k=x_k+n_k

Fk=I,Γk=0,H=I,x0=ux0,P0=αI,Qkv=CnkF_k=I, \varGamma _k=0, H=I, x_0=u_{x_0}, P_0=\alpha I, Q_{k}^{v}=C_{n_k}

x^1∣0=Fkx^0∣0=ux0\hat{x}_{1|0}=F_k\hat{x}_{0|0}=u_{x_0}

P1∣0=F0P0∣0F0T+Γ0G0wΓ0T=αIP_{1|0}=F_0P_{0|0}F_{0}^{T}+\varGamma _0G_{0}^{w}\varGamma _{0}^{T}=\alpha I

K1=P1∣0H1T(H1P1∣0H1T+Q1v)−1=αI(αI+Cn1)−1=αIαI+Cn1K_1=P_{1|0}H_{1}^{T}\left( H_1P_{1|0}H_{1}^{T}+Q_{1}^{v} \right) ^{-1}=\alpha I\left( \alpha I+C_{n_1} \right) ^{-1}=\frac{\alpha I}{\alpha I+C_{n_1}}

x^1∣1=x^1∣0+K1(z1−Hx^1∣0)=ux0+αIαI+Cn1(x1+n1−ux0)\hat{x}_{1|1}=\hat{x}_{1|0}+K_1\left( z_1-H\hat{x}_{1|0} \right) =u_{x_0}+\frac{\alpha I}{\alpha I+C_{n_1}}\left( x_1+n_1-u_{x_0} \right)

P1∣1=P1∣0−K1H1P1∣0=αI−α2IαI+Cn1P_{1|1}=P_{1|0}-K_1H_1P_{1|0}=\alpha I-\frac{\alpha ^2I}{\alpha I+C_{n_1}}

作业1:已知小车在一维空间匀速运动,假设激光传感器可以测量小车位置,模型噪声和量测噪声满足wk∼N(0,Q)w_ k\sim N(0,Q),vk∼N(0,R)v_ k\sim N(0,R).请给出:

(1)小车的运动模型和量测模型

(2)给出对应的卡尔曼滤波器的五个基本公式

xk+1=Fkxk+[w1∣kw2∣k]Tx_{k+1}=F_kx_k+\left[ \begin{matrix} w_{1|k}& w_{2|k}\\ \end{matrix} \right] ^T

zk=Hkxk+vkz_k=H_kx_k+v_k

Fk=[1T01],Hk=[10],xk=[xkx˙k]TF_k=\left[ \begin{matrix} 1& T\\ 0& 1\\ \end{matrix} \right] , H_k=\left[ \begin{matrix} 1& 0\\ \end{matrix} \right] , x_k=\left[ \begin{matrix} x_k& \dot{x}_k\\ \end{matrix} \right] ^T

x^k∣k−1=Fk−1x^k−1∣k−1\hat{x}_{k|k-1}=F_{k-1}\hat{x}_{k-1|k-1}

Pk∣k−1=Fk−1Pk−1∣k−1Fk−1T+QP_{k|k-1}=F_{k-1}P_{k-1|k-1}F_{k-1}^{T}+Q

Kk=Pk∣k−1HkT(HkPk∣k−1HkT+R)−1K_k=P_{k|k-1}H_{k}^{T}\left( H_kP_{k|k-1}H_{k}^{T}+R \right) ^{-1}

x^k∣k=x^k∣k−1+Kk(zk−Hx^k∣k−1)\hat{x}_{k|k}=\hat{x}_{k|k-1}+K_k\left( z_k-H\hat{x}_{k|k-1} \right)

Pk∣k=Pk∣k−1−KkHkPk∣k−1P_{k|k}=P_{k|k-1}-K_kH_kP_{k|k-1}

作业2:已知一个线性离散系统及其量测方程为

xk=xk−12+3xk−1+cos⁡(5k)+wk−1,wk∼N(0,Q)x_k=x_{k-1}^{2}+3x_{k-1}+\cos \left( 5k \right) +w_{k-1}, w_k\sim N\left( 0,Q \right)

zk=xk3+vk−1,vk∼N(0,R)z_k=x_{k}^{3}+v_{k-1}, v_k\sim N\left( 0,R \right)

其中Q=1,R=2Q=1,R=2。初始信息x0=1,P0=1x_ 0=1,P_ 0=1,请给出

(1)扩展卡尔曼滤波的五个基本公式

(2)给出上述系统的一步预测结果

fk−1x=2x^k−1∣k−1+3,fk−1w=1f_{k-1}^{x}=2\hat{x}_{k-1|k-1}+3, f_{k-1}^{w}=1

x^k∣k−1=x^k−1∣k−12+3x^k−1∣k−1+cos⁡(5k)\hat{x}_{k|k-1}=\hat{x}_{k-1|k-1}^{2}+3\hat{x}_{k-1|k-1}+\cos \left( 5k \right)

Pk∣k−1=(2x^k−1∣k−1+3)Pk−1∣k−1(2x^k−1∣k−1+3)T+Q=(2x^k−1∣k−1+3)2Pk−1∣k−1+1P_{k|k-1}=\left( 2\hat{x}_{k-1|k-1}+3 \right) P_{k-1|k-1}\left( 2\hat{x}_{k-1|k-1}+3 \right) ^T+Q=\left( 2\hat{x}_{k-1|k-1}+3 \right) ^2P_{k-1|k-1}+1

hk−1x=3x^k∣k−12,hk−1v=1h_{k-1}^{x}=3\hat{x}_{k|k-1}^{2}, h_{k-1}^{v}=1

Kk=Pk∣k−1(3x^k∣k−12)T((3x^k∣k−12)Pk∣k−1(3x^k∣k−12)T+R)−1K_k=P_{k|k-1}\left( 3\hat{x}_{k|k-1}^{2} \right) ^T\left( \left( 3\hat{x}_{k|k-1}^{2} \right) P_{k|k-1}\left( 3\hat{x}_{k|k-1}^{2} \right) ^T+R \right) ^{-1}

x^k∣k=x^k∣k−1+Kk(zk−(3x^k∣k−12)x^k∣k−1)\hat{x}_{k|k}=\hat{x}_{k|k-1}+K_k\left( z_k-\left( 3\hat{x}_{k|k-1}^{2} \right) \hat{x}_{k|k-1} \right)

Pk∣k=Pk∣k−1−Kk(3x^k∣k−12)Pk∣k−1P_{k|k}=P_{k|k-1}-K_k\left( 3\hat{x}_{k|k-1}^{2} \right) P_{k|k-1}

x^1∣0=1+3=4\hat{x}_{1|0}=1+3=4


第六章:非线性系统状态滤波理论

当系统模型为线性、高斯分布时,在每个递推估计过程中,概率密度分布依然保持高斯性质。此时,可通过线性最优的卡尔曼滤波来传递和更新分布的均值和方差。

卡尔曼滤波是最小均值平方根误差的线性最优滤波器,也是最广泛使用的经典线性滤波器。但大多数情况下,目标系统模型和观测模型不一定是线性、高斯分布型。因而不能通过线性卡尔曼滤波求得其最优解析解。

对于非线性情况有一些次优解决方案,如一阶泰勒级数展开的扩展卡尔曼滤波(EKF)、使用确定性抽样点的无损卡尔曼滤波UKF、序贯重要性抽样SIS滤波算法等。

定义

离散时间非线性随机动态系统

xk+1=fk(xk,wk)x_{k+1}=f_k\left( x_k,w_k \right)

zk=hk(xk,vk)z_k=h_k\left( x_k,v_k \right)

xkx_ k是kk时刻的系统状态向量,fkf_ k是系统状态转移函数,wkw_ k是过程演化噪声,zkz_ k是kk时刻对系统的量测向量,hxh_ x是量测函数,而vkv_ k是量测噪声。

其中fkf_ k和hxh_ x不一定是线性函数,wkw_ k和vkv_ k不一定是高斯分布。

扩展卡尔曼滤波器EKF

扩展卡尔曼滤波器算法实质上是一种在线线性化的算法,即按名义轨迹进行线性化处理,再利用Kalman滤波公式进行计算。

一阶扩展卡尔曼滤波算法

实际非线性滤波处理,通常将过程噪声和观测噪声近似为高斯分布,协方差分别为QwkQ_ {w_ k}和QvkQ_ {v_ k},均值假定为0.

基于U变换的UKL滤波(无损卡尔曼滤波)

在处理状态方程时,首先进行无损变换,然后使用U变换后的状态变量进行滤波估值,以减小估计误差。

无损变换是输入N维随机向量xx,通过非线性函数进行传播得到输出yy的统计特性。

  • U变换:针对输入随机信号xx设计一系列的点ξi,i=0,1,⋯ ,L\xi_ i, i=0,1,\cdots,L称为Sigma点集,计算其经过f(⋅)f(\cdot)传播所得到的结果γi,i=0,1,⋯ ,L\gamma_ i, i=0,1,\cdots,L,然后基于这些结果计算yˉ,Py\bar{y},P_ y, Sigma点集的数量为2N+1

由于UKF保存了非线性次项,用UKF求得的均值和方差与真值一致,而EKF则由于线性化损失了一部分二次项值。

对整个非线性方程而言,UKF也会损失掉一些高次项信息,然而总体上可以取得优于EKF的滤波性能。当状态方程和测量方程非线性较大时,EKF和UKF的性能差别比较明显。

粒子滤波理论

由于在现代信号处理、目标跟踪、自动控制、计算机视觉等领域存在大量的非线性和非Gauss随机情况。系统概率分布解析式不可求或不易求,从而发展起来一种新的基于随机采样的滤波算法,一种基于仿真的统计滤波方法。

基于随机采样的滤波算法是利用状态空间加权随机样本集(粒子)来近似系统状态的后验概率密度函数,形成了粒子滤波理论(PF)

Monte Carlo仿真的随机采样:
  • 标准均匀分布伪随机采样

    其概率分布函数为:

F(x)={0,x<0x,0≤x≤11,x>1F\left( x \right) =\left\{ \begin{array}{c} 0, x<0\\ x, 0\le x\le 1\\ 1, x>1\\ \end{array} \right.

​ 一种仿真生成x(i)x^{(i)}伪随机数的方法是产生[0,1][0,1]随机数的同余法,记x∼u[0,1]x\sim u[0,1]

  • 非均匀分布伪随机–反变换采样法

    设随机变量xx具有概率分布函数F(x)F(x),xx属于实数集R,按分布函数的单调性,逆函数F−1F^{-1}

  • Gauss分布抽样法

  • 直接抽样法

  • 舍选抽样法

序贯重要性采样法SIS

序贯重要性采样算法是一种Monte Carlo采样方法,Monte Carlo仿真实现递推Bayes滤波

SIS关键思想是根据一组带有相应权值的随机样本来表示需要的后验概率密度函数,而且基于这些样本和权值来计算估计值。

定义:

设概率密度函数p(x)p(x),又xi=1,2,⋯ ,N(i)∼q(x)x_ {i=1,2,\cdots,N}^{(i)}\sim q(x)是由一个建议的容易采样的概率密度函数q(x)q(x)进行采样而产生的样本,称为采样粒子,而q(⋅)q(\cdot)为重要性密度函数,那么对pdfp(⋅)pdf p(\cdot)的加权近似就可以表示为:

p(x)≈∑i=1Nλ(i)δ(x−x(i)),∑i=1Nλ(i)=1p\left( x \right) \approx \sum_{i=1}^N{\lambda ^{\left( i \right)}\delta \left( x-x^{\left( i \right)} \right)}\text{,} \sum_{i=1}^N{\lambda ^{\left( i \right)}=1}

其中:λ(i)∝p(x(i))q(x(i))\lambda ^{\left( i \right)}\propto \frac{p\left( x^{\left( i \right)} \right)}{q\left( x^{\left( i \right)} \right)} , 称为正则权值

重要性密度函数q(x)q(x),要与p(x)p(x)近似的概率分布有相同的形式。一般的,重要函数与这个概率分布越近似,则粒子滤波器性能就越好。


第七章:目标跟踪算法

目标跟踪本质是通过滤波,对目标运动状态进行估计和预测,来消除目标相关的不确定性。

航迹是目标跟踪领域经常提到的概念:指基于同一目标的一组量测信息获得的目标状态轨迹的估值,本质上就是目标跟踪滤波结果。

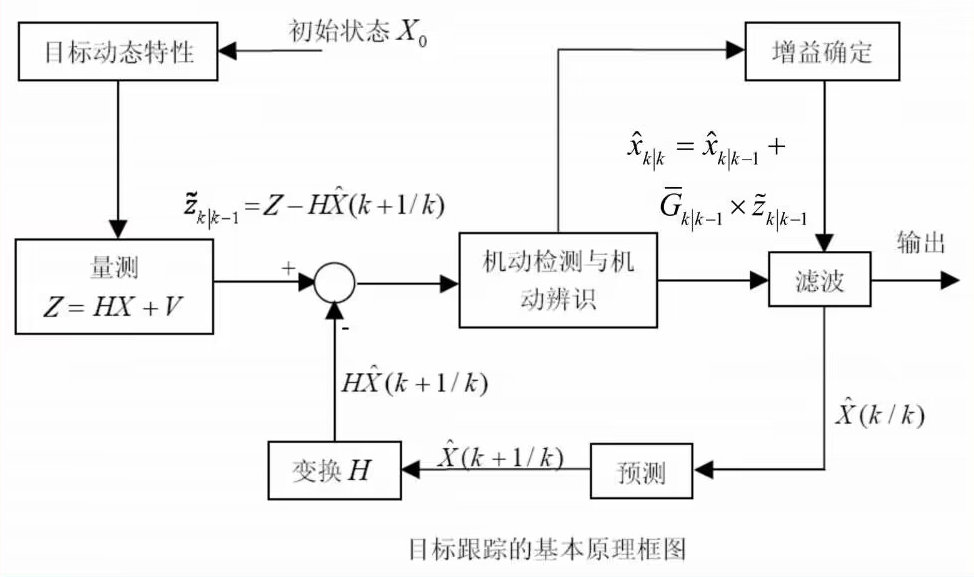
单目标跟踪
单目标

  • 首先先由量测Z和状态预测量计算残差(新息)向量x~k∣k−1\tilde{x}_ {k|k-1}
  • 然后根据x~k∣k−1\tilde{x}_ {k|k-1}的变化进行动机检测或动机辨识
  • 其次按照某一准则或逻辑调整滤波增益与协方差矩阵或者实时辨识出目标机动特性
  • 最后由滤波算法得到目标的估计值和预测值,从而完成目标跟踪功能
滤波残差:

滤波残差,考虑一个处于跟踪维持阶段的目标,设k-1时刻状态变量的滤波预报值为x^k∣k−1\hat{x}_ {k|k-1},通过观测方程可以求出kk时刻量测的预测值z^k∣k−1\hat{z}_ {k|k-1},它与k时刻量测信号之差为滤波残差向量。

滤波残差就是前面讲的”新息“

滤波残差:z~k∣k−1=zk−z^k∣k−1\tilde{z}_ {k|k-1}=z_ k-\hat{z}_ {k|k-1}

其中:z^k∣k−1=Hkx^k∣k−1\hat{z}_ {k|k-1}=H_ k\hat{x}_ {k|k-1}

残差协方差阵SkS_ k:

已知:zk=Hkxk+vkz_ k=H_ kx_ k+v_ k

定义:Sk=HkPk∣k−1HkTS_ k=H_ kP_ {k|k-1}H_ {k}^{T}

残差向量范数dk2d_ k^2

dk2=z~k∣k−1TSk−1z~k∣k−1d_ {k}^{2}=\tilde{z}_ {k|k-1}^{T}S_ {k}^{-1}\tilde{z}_ {k|k-1}

常速CV模式

在三维物理空间的点目标运动,可以用三维的位移和速度向量来描述:

位移向量:(x,y,z)(x,y,z)

速度向量:(x˙,y˙,z˙)(\dot{x},\dot{y},\dot{z})

目标状态:x=(x,x˙,y,y˙,z,z˙)Tx=(x,\dot{x},y,\dot{y},z,\dot{z})^T

非机动目标的动态模型一般可描述为:

x˙(t)=diag[ACV,ACV,ACV]x(t)+diag[ΓCV,ΓCV,ΓCV]w(t)\dot{x}(t)=\mathrm{diag}\left[ A_{CV},A_{CV},A_{CV} \right] x\left( t \right) +\mathrm{diag}\left[ \Gamma _{CV},\Gamma _{CV},\Gamma _{CV} \right] w\left( t \right)

ACV=[0100],ΓCV=[01]\\ A_{CV}=\left[ \begin{matrix} 0& 1\\ 0& 0\\ \end{matrix} \right] , \Gamma _{CV}=\left[ \begin{array}{c} 0\\ 1\\ \end{array} \right]

离散化模型(T采样间隔)

xk+1=diag[FCV,FCV,FCV]xk+diag[ECV,ECV,ECV]wkx_{k+1}=\mathrm{diag}\left[ F_{CV},F_{CV},F_{CV} \right] x_k+\mathrm{diag}\left[ E_{CV},E_{CV},E_{CV} \right] w_k

FCV=[1T01],ECV=[T22T]F_{CV}=\left[ \begin{matrix} 1& T\\ 0& 1\\ \end{matrix} \right] , E_{CV}=\left[ \begin{array}{c} \frac{T^2}{2}\\ T\\ \end{array} \right]

具体给出一个状态分量(y方向)的具体表达式:

y方向位移:

yk+1=yk+T×y˙k+T22×wk,yy_{k+1}=y_k+T\times \dot{y}_k+\frac{T^2}{2}\times w_{k,y}

y方向速度:

y˙k+1=yk+T×wk,y\dot{y}_{k+1}=y_k+T\times w_{k,y}

噪声协方差为:

cov(Ewk)=diag[ECVQwx,ECVQwy,ECVQwz]\mathrm{cov}\left( Ew_k \right) =\mathrm{diag}\left[ E_{CV}Q_{w}^{x},E_{CV}Q_{w}^{y},E_{CV}Q_{w}^{z} \right]

其中Qwx,y,z代表wk各分量方差,ECV=[T33T22T22T]\text{其中}Q_{w}^{x,y,z}\text{代表}w_k\text{各分量方差,}E_{CV}=\left[ \begin{matrix} \frac{T^3}{3}& \frac{T^2}{2}\\ \frac{T^2}{2}& T\\ \end{matrix} \right]

在一般飞行器的常速模型分析中,主要研究水平机动,有时允许z方向速度有机动,此时方程:

zk+1=zk+T×wk,zz_{k+1}=z_k+T\times w_{k,z}

{x˙k+1=x˙k+Tωk,xy˙k+1=y˙k+Tωk,yz˙k+1=z˙k+Tωk,zxk+1=xk+Tx˙k+T22ωk,xyk+1=yk+Ty˙k+T22ωk,yzk+1=zk+Twk,z  ⇒  Fk=[1T0000010000001T00000100000010000001],Γk=[T2/200T000T2/200T000T00T]\left\{ \begin{array}{c} \dot{x}_{k+1}=\dot{x}_k+T\omega _{k,x}\\ \dot{y}_{k+1}=\dot{y}_k+T\omega _{k,y}\\ \dot{z}_{k+1}=\dot{z}_k+T\omega _{k,z}\\ x_{k+1}=x_k+T\dot{x}_k+\frac{T^2}{2}\omega _{k,x}\\ y_{k+1}=y_k+T\dot{y}_k+\frac{T^2}{2}\omega _{k,y}\\ z_{k+1}=z_k+Tw_{k,z}\\ \end{array} \right. \,\,\Rightarrow \,\,F_k=\left[ \begin{matrix} 1& T& 0& 0& 0& 0\\ 0& 1& 0& 0& 0& 0\\ 0& 0& 1& T& 0& 0\\ 0& 0& 0& 1& 0& 0\\ 0& 0& 0& 0& 1& 0\\ 0& 0& 0& 0& 0& 1\\ \end{matrix} \right] , \varGamma _k=\left[ \begin{matrix} T^2/2& 0& 0\\ T& 0& 0\\ 0& T^2/2& 0\\ 0& T& 0\\ 0& 0& T\\ 0& 0& T\\ \end{matrix} \right] \\

雷达目标跟踪的状态与量测方程

x=[rr˙θθ˙],{rk+1=rk+Tr˙k+T22r~r˙k+1=r˙k+Rr~θk+1=θk+Tθ˙k+T22θ~θ˙k+1=θ˙k+Tθ~  ⇒  Fk=[1T000100001T0001],Γk=[T220T00T220T]x=\left[ \begin{array}{c} r\\ \dot{r}\\ \theta\\ \dot{\theta}\\ \end{array} \right] , \left\{ \begin{array}{c} r_{k+1}=r_k+T\dot{r}_k+\frac{T^2}{2}\tilde{r}\\ \dot{r}_{k+1}=\dot{r}_k+R\tilde{r}\\ \theta _{k+1}=\theta _k+T\dot{\theta}_k+\frac{T^2}{2}\tilde{\theta}\\ \dot{\theta}_{k+1}=\dot{\theta}_k+T\tilde{\theta}\\ \end{array} \right. \,\,\Rightarrow \,\, F_k=\left[ \begin{matrix} 1& T& 0& 0\\ 0& 1& 0& 0\\ 0& 0& 1& T\\ 0& 0& 0& 1\\ \end{matrix} \right] , \varGamma _k=\left[ \begin{matrix} \frac{T^2}{2}& 0\\ T& 0\\ 0& \frac{T^2}{2}\\ 0& T\\ \end{matrix} \right]


第八章:多传感器参数估计融合处理理论

估计融合:就是传统估计理论与数据融合理论的有机融合,或者说是针对估计问题的数据融合,即研究在估计未知量的过程中,如何最佳利用多个数据集合中所包含的有用信息。这些数据集合通常来自多个信息源,大多数情况是多个传感器。

目前的估计融合算法都与融合结构密切相关,融合结构大致可以分为三类:集中式、分布式、混合式

集中式融合

所有传感器量测数据都传送到一个中心处理器进行处理和融合,所以也称为中心式融合或量测融合

融合中心可以利用所有传感器的原始量测数据,没有任何信息的损失,因而融合结果是最优的,但这种结构需要频带很宽的数据传输链路来传输原始数据,并且需要有较强处理能力的中心处理器,所以工程上实现较为困难

常见的集中式融合算法有三种:并行滤波、序贯滤波、数据压缩滤波

分布式融合

分布式融合也成为传感器级融合或自主式融合。在这种结构中,每个传感器都有自己的处理器,进行一些预处理,然后把中间结果送到中心节点进行融合处理。

由于各传感器都具有自己的局部处理器,能够形成局部航迹,所以在融合中心也主要是对各局部航迹进行融合,所以这种融合方式也称为航迹融合。

这种机构因对信道容量要求低,系统生命力强,在工程上易于实现而得到很大重视,并成为信息融合研究的重点。

航迹:在多传感器融合系统中,每个传感器的跟踪器给出的航迹称为局部航迹,或称传感器航迹,在融合中心将各个局部航迹进行处理形成新的航迹叫系统航迹或全局航迹。

在目标跟踪中,往往不可能将目标以往所有时刻的位置记录下来,但只要给出目标的运动假定(状态方程),以及当前时刻的状态估计,即可预测未来时刻的运动状态,或回推目标以往的位置及运动状态,因此在目标航迹跟踪中,航迹即当前时刻的状态估计及目标运动假定的综合。

分布式估计融合过程包含的步骤

航迹关联和航迹状态估计。在航迹关联过程中,来自不同传感器的航迹进行关联以形成系统航迹,每个传感器的航迹相应于一个单独的假定目标。给定了一个关联过程之后,系统航迹的估计就可以通过融合关联上的传感器航迹的状态估计来得到。

联邦滤波器

由若干个子滤波器和一个主滤波器组成,各个子滤波器独立进行时间更新和量测更新,主滤波器进行时间更新和对子滤波器的估计信息进行融合处理

技术
  • 方差上界技术
  • 信息分配原则
具体实现结构:
  • 融合-重置式结构FR:信息在各子滤波器和主滤波器之间按一定比例分配,各子滤波器独立地进行时间更新和量测更新,主滤波器仅进行时间更新
  • 零重置式结构ZR:主滤波器分配得到系统的全部信息,子滤波器状态方程没有信息
  • 无重置式结构NR:在初始时刻,各子滤波器根据所对应传感器的精度高低按一定的比例分配系统的信息,主滤波器无信息分配,其输出仅由时间更新确定。
  • 重调式结构RS:各子滤波器融合时仅将一部分信息送入主滤波器,,其余信息自己保留。

运算速度:NR最快,因为没有重置,ZR和RS居中,FR最慢,因为必须等主滤波器的融合结束之后各子滤波器才能得到自己的重置值。

容错能力:NR较好,因为不存在各子滤波器之间的交叉污染,误差被局限在一个子滤波器内,ZR和RS居中,FR较差。

联邦滤波器的工作流程

  1. 信息分配

    信息分配就是在各子滤波器和主滤波器之间分配系统的信息,包括系统的过程信息QwkQ_ {w_ k}和Pk∣kgP_ {k|k}^g

    {Qwki=βi−1Qwk,Qwk为过程噪声协方差Pk∣ki=βi−1Pk∣kg,βi>0&∑i=1Nβi+βm=1x^k∣ki=x^k∣kg,i=1,2,⋯ ,N,m  \left\{ \begin{array}{c} Q_{w_k}^{i}=\beta _{i}^{-1}Q_{w_k}, Q_{w_k}\text{为过程噪声协方差}\\ P_{k|k}^{i}=\beta _{i}^{-1}P_{k|k}^{g}, \beta _i>0 \& \sum_{i=1}^N{\beta _i+\beta _m=1}\\ \hat{x}_{k|k}^{i}=\hat{x}_{k|k}^{g}, i=1,2,\cdots ,N,m\,\,\\ \end{array} \right.

  2. 时间更新

    {x^k+1∣ki=Fkx^k∣kiPk+1∣ki=FkPk∣kiFkT+ΓkQwkiΓkT\left\{ \begin{array}{c} \hat{x}_{k+1|k}^{i}=F_k\hat{x}_{k|k}^{i}\\ P_{k+1|k}^{i}=F_kP_{k|k}^{i}F_{k}^{T}+\varGamma _kQ_{w_k}^{i}\varGamma _{k}^{T}\\ \end{array} \right.

  3. 量测更新(只在子滤波器中进行)

    {(Pk+1∣k+1i)−1=(Pk+1∣ki)−1+(Hk+1i)Qvk+1i−1(Hk+1i)−1(Pk+1∣k+1i)−1×x^k+1∣k+1i=(Pk+1∣ki)−1x^k+1∣ki+(Hk+1i)TQvk+1i−1zk+1i\left\{ \begin{array}{c} \left( P_{k+1|k+1}^{i} \right) ^{-1}=\left( P_{k+1|k}^{i} \right) ^{-1}+\left( H_{k+1}^{i} \right) Q_{v_{k+1}^{i}}^{-1}\left( H_{k+1}^{i} \right) ^{-1}\\ \left( P_{k+1|k+1}^{i} \right) ^{-1}\times \hat{x}_{k+1|k+1}^{i}=\left( P_{k+1|k}^{i} \right) ^{-1}\hat{x}_{k+1|k}^{i}+\left( H_{k+1}^{i} \right) ^TQ_{v_{k+1}^{i}}^{-1}z_{k+1}^{i}\\ \end{array} \right.

  4. 信息融合(将各个局部滤波器的局部估计信息和主滤波器的信息按下式进行融合)

    {Pk+1∣k+1g=[(Pk+1∣k+11)−1+⋯+(Pk+1∣k+1N)−1+(Pk+1∣km)−1]−1x^k+1∣k+!g=Pk+1∣k+1g[(Pk+1∣k+11)−1x^k+1∣k+11+⋯+(Pk+1∣k+1N)−1x^k+1∣k+1N+(Pk+1∣km)−1x^k+1∣km]\left\{ \begin{array}{c} P_{k+1|k+1}^{g}=\left[ \left( P_{k+1|k+1}^{1} \right) ^{-1}+\cdots +\left( P_{k+1|k+1}^{N} \right) ^{-1}+\left( P_{k+1|k}^{m} \right) ^{-1} \right] ^{-1}\\ \hat{x}_{k+1|k+!}^{g}=P_{k+1|k+1}^{g}\left[ \left( P_{k+1|k+1}^{1} \right) ^{-1}\hat{x}_{k+1|k+1}^{1}+\cdots +\left( P_{k+1|k+1}^{N} \right) ^{-1}\hat{x}_{k+1|k+1}^{N}+\left( P_{k+1|k}^{m} \right) ^{-1}\hat{x}_{k+1|k}^{m} \right]\\ \end{array} \right.