光学生成模型
-
作者信息
加州大学洛杉矶分校的团队
做的是深度学习光学、光学计算、计算成像、生物传感的研究,近两年研究的内容包括:扩散模型、衍射处理器、衍射网络、全光图像去噪、全光成像
随着数字生成模型变得越来越大,快速和节能地进行扩展推理成为一个挑战。
此文提出了受扩散模型启发的光学生成模型:
- 浅层和快速的数字编码器将随机噪声映射到相位图案,作为目标数据分布的光学生成种子
- 自由空间的重构编码器通过联合训练,以全光方式处理这些生成种子,并根据目标数据分布生成前所未见的图像。
- 除了照明功率和通过浅层编码生成随机种子之外,这个光学生成模型在合成图像过程中不消耗算力。
实验内容:
- 数据集:MNIST, Fashion-MNIST, Butterflies-100, Celeb-A datasets, Van Gogh’s paintings and drawings
- 生成了对应数据集的图像,实现了单色和多色的光学生成效果
性能:与基于数字神经网络的生成模型相当。
生成模型:
创作多样化、高质量的合成图像
应用领域:自然语言处理、生成音乐作品、设计新型蛋白结构……
现有的数字生成模型的限制:随着模型不断扩大,算力、内存需求逐渐扩大,推理时间逐渐延长
改进目标:缩小模型体积,降低能耗,提升推理速度,兼具能效性和可扩展性。
快照式光学生成模型
步骤:
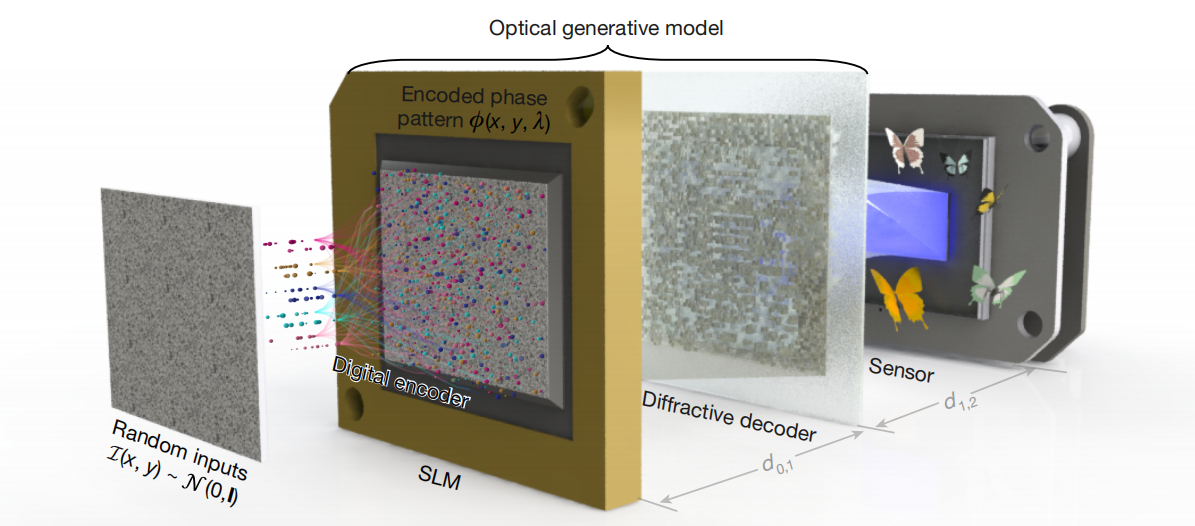
准备:
- 输入:符合正态分布的随机二维输入信号
- 经数字编码器处理,提取潜在特征并编码至相位通道
- 光学生成种子:这些随机噪声生成的相位编码,作为光学生成种子
- 加载到空间光调制器中
编码:相干照明条件下,光场携带了这些编码相位图案
解码:通过针对特定目标数据分布优化的衍射解码器
snapshot模型细节
数字编码模型
作用:将一个随机输入转换成一个有意义的二维信号,作为光学生成种子。
- 输入:从零均值、单位协方差的高斯分布采样得到噪声图样 。
- 数字编码器(MLP 变体):
- 结构: 个全连接层 + 激活 ;
- 功能:将噪声映射为中间表示 ,并额外预测缩放因子 (用于后续幅度/能量归一或亮度控制);
- 形状处理:若中间为向量,则在末端重塑为 的二维场。
- (可选特化)梵高风格分支:编码器具体分解为
- 噪声特征处理器(提取与重排噪声模式);
- 计算机模拟场传播器(数值域中模拟/近似光场传播的算子,注入物理先验);
- 复场转换器(将实值表示转为复振幅/相位场,以匹配光学系统的调制需求)。
- 输出到光学模型:得到二维编码信号 (及 ),作为光学生成模块的输入。
光学生成模型
包括SLM和衍射解码
SLM相位编码:
-
SLM 相位编码:把数字编码器输出的二维实值信号 转换为相位分布 ,范围 。(归一化到区间)
-
构造复光场:利用欧拉公式把相位转化为复光场分布 。
自由空间传播建模:
通过角谱法,用传递函数 在频域计算场在介质中传播距离 后的分布 。
角谱法:光场传播方法,通过傅里叶变换把空间域的光场变为频域表示,再乘上传递函数(描述介质传播效应),最后逆傅里叶回到空间域。
自由空间传播算子
用角谱法表示相邻平面距离为 的传播:衍射解码:
描述“光在空间中传播”的物理过程(传播算子),
描述“光经过相位调制层”的物理过程(相位算子);
两者交替组合,就构成了完整的衍射解码器网络。-
相位调制算子
第 个相位解码层为仅相位调制: -
多层解码迭代(传播 + 调制 级联) 总的前向传播为:
-
最终在输出平面形成光场
传感器平面强度
多波长扩展
描述了解码层的相位调制在不同波长下的校正方式。
因为材料的折射率 随波长 变化,不同波长的光通过同一层时,其相位调制效果会发生比例变化。
训练策略
光学生成模型的训练采用**“教师-学生”范式**:先用数字 DDPM 学习目标分布,再用光学模型模仿教师模型输出,通过 MSE + KL 散度 联合损失保证像素对齐和分布对齐,从而实现稳定高效的光学生成能力。
当教师生成模型学习到目标分布 后,快照光学生成模型的训练在教师模型的辅助下进行。在此框架下,提出的模型训练目标公式为:
其中:
- :表示教师模型学到的分布。
- MSE:均方误差,用来衡量生成图像之间的像素差异。
- KL():Kullback–Leibler 散度,用来衡量两个分布之间的差异。
- :由快照光学生成模型捕获的分布, 是其可优化参数。
- :教师模型生成的样本图像。
- :光学生成模型生成的样本图像。
- :由数字编码器预测的缩放因子。
- :经验系数,用来平衡 MSE 与 KL 项。
光学生成模型学习困难的原因:
非线性弱 / 表达力有限:
光学系统主要依赖“相位调制 + 自由空间传播”,相比数字神经网络,参数量和非线性能力有限。如果直接用真实图像数据训练,它很难一开始就覆盖复杂的数据分布,容易陷入收敛困难。物理噪声和约束:
光学传播中存在器件噪声、相位量化、动态范围限制等,这些都会干扰训练。如果直接拿真实数据做目标,梯度反传路径更长,收敛会非常慢。分布复杂度:
真实数据分布 (例如 CelebA、Butterflies-100)维度极高、模式复杂,光学模型本身更像是一个“结构受限”的生成网络,直接为什么教师模型的分布与真实数据分布近似,但是却更容易学习?
- 真实数据分布:高维、非高斯、复杂多模态,包含噪声、细节和长尾样本(例如人脸的各种姿态、表情、光照)
教师分布 :是一个平滑化的近似。数字教师模型(如 DDPM)在训练时,实际上会“吸收”掉一些噪声和复杂局部模式,提取出主要的统计特征。
- 如果直接用真实数据作为目标,光学生成模型需要在像素级与数据对齐 → 梯度震荡大,容易不收敛。
教师模型提供的分布 通常通过概率密度或样本直方图表达 → 光学模型只需要保证自己生成的样本“统计上接近教师样本”。
- 教师模型已经完成了最复杂的部分(拟合真实数据分布),简化了噪声、平滑了细节、提供了稳定的梯度信号
知识蒸馏:
在深度学习里常见的“知识蒸馏”正是这个逻辑:学生模型(弱模型)直接拟合真实数据难,但通过模仿教师模型(强模型)的“软目标”,训练会更快、更稳、更准确。
模型参数细节
项目 MNIST Fashion-MNIST Butterflies-100 CelebA Van Gogh 风格 条件/类别 有标签(10 类) 有标签(10 类) 无显式标签 无显式标签 有标签:{architecture, plants, person} 第一层输入 同左 同左 输入噪声分辨率 32×32 32×32 32×32 32×32 80×80(并加入扰动以扩大潜在空间覆盖) 类别嵌入维度 32 32 — — 80 数字编码器层数 3(全连接) 3 3 3 3 每层神经元数 (RGB) 3xy(RGB) xy + l 激活函数 LeakyReLU(slope=0.2) 同左 同左 同左 同左 光学:解码层数 1 1 1 1 1 传播距离 d{0,1}=120.1 mm;d{1,2}=96.4 mm 同左 同左 同左 同左 相位归一化系数 2.0 同左 同左 同左 同左 相位上采样 x、y 方向各×10 同左 同左 同左 同左 物体平面尺寸 / 分辨率 2.56 mm × 2.56 mm / 320×320 同左 同左 同左 8 mm × 8 mm / 1000×1000 成像平面尺寸 / 分辨率 5.12 mm × 5.12 mm / 640×640(训练时下采样×10到 32×32 计损失) 同左 同左 同左 5.12 mm × 5.12 mm / 640×640 照明波长 单色:520 nm;多色:450/520/638 nm 同左 同左 同左 同左 解码层可训练参数数 400×400 同左 同左 同左 1000×1000 教师模型(Teacher) 数字 DDPM(先学 p_{\text{data}}) 同左 同左 同左 Stable Diffusion v1.5 微调于 vangogh2photo;并由 GIT-base 加标题 扩散设定(教师) T=1000; 线性:0.00085 → 0.012 同左 同左 同左 同左 框架 / 硬件 PyTorch 2.21;4×RTX 4090 同左 同左 同左 同左
迭代式光学生成模型
迭代式模型实现细节
训练时使用正向扩散过程,在推理时使用其逆过程
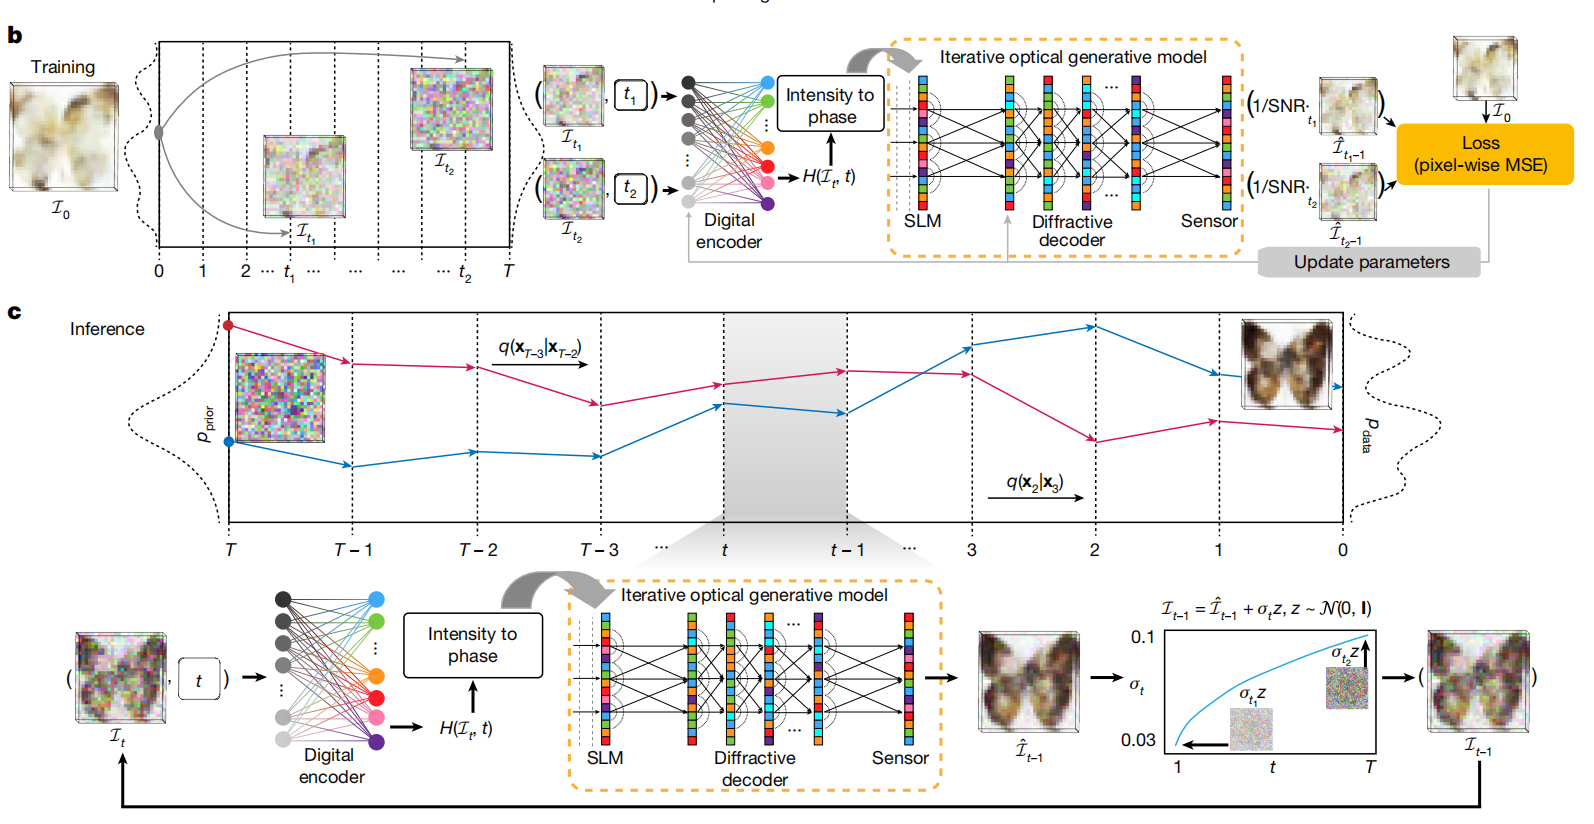
正向扩散:
加噪过程:
从真实图像 出发,生成第 步带噪样本 :
含义:,。
我们用 (带噪)和标签 去训练模型“如何还原 ”。:每一步加多少噪声;
:每一步保留多少原图;
:到第 步时,原图还剩下多少比例(累计乘积)
训练过程:
引入了时间步权重 SNR:
用光学链路对 前向一次,得到像面强度特征 :
(或文中记为 的预测量)。最小化下式:
- 输入:(带噪) + 时间步 ;
- 输出:通过“相位编码 → 光学传播/解码”的强度预测;
- 目标:让模型预测的量接近与 成比例的“干净信号”,SNR 负责不同步的权重。
逆过程:
起点:
从纯噪声图像开始
迭代步骤:
对时间步 依次执行以下操作:
- 相位生成(数字编码器)
- 输入:当前带噪图像 和时间步
- 输出:对应的相位分布
- 含义:告诉 SLM 在这一时间步该如何调制光场。
- 光学传播(光学链路)
-
操作:把相位 加载到 SLM,上光场传播并经过多层衍射解码器。
-
输出:像面强度
-
含义:光学部分给出了该时间步下的“去噪预测”。
- 更新图像(去噪采样)
-
把输出强度线性归一化到区间 ,再加上高斯噪声:
-
噪声 ,当 时设 。
-
噪声幅度由方差控制:
循环终点:
当 时,得到最后的 ,再经过一次光学链路,最终生成图像为:
优势:
-
与snapshot比较,迭代式模型能生成背景更清晰、质量更高的图像。
-
训练过程不会出现模式坍缩现象。(通过连续迭代将分布映射任务分解为由不同时间步控制的独立高斯过程)
模式坍缩: 生成模型训练中的一种常见失败现象。它指的是模型无法捕捉到训练数据的所有多样性,只学会了生成其中少数几种或一小部分“模式”的图像。
为什么快照模式更容易产生模式坍缩:
快照式模型是“一步到位”的,它通过单一的光学转换直接从输入种子生成图像。这种方法存在两个主要问题:
- 缺乏反馈和纠错机制: 这种单次转换的训练过程没有分步优化的机会。如果某个图像模式更容易被生成,模型就会“偷懒”,只专注于生成这种模式,而无法纠正自己。
- 单一转换的局限性: 一个单层光学解码器可能无法执行足够复杂的变换来覆盖整个数据分布,导致它只能找到一个局部最优解,即生成部分图像模式,而忽略其他。
为什么迭代式模型能避免模式坍缩:
迭代式模型则采用了分步去噪的策略
- 任务分解: 它不试图一次性完成复杂的生成任务,而是将其分解为一系列简单、可控的去噪步骤。模型从一个充满噪声的图像开始,然后逐步将其去噪成一个清晰的图像。
- 强制探索多样性: 为了成功完成整个去噪过程,模型必须学习如何处理所有不同程度的噪声,并精确地将它们映射到正确的图像分布上。这迫使模型去探索和学习训练数据集中的每一个“模式”,而不是仅仅生成最容易的那几个。
- 多层级处理: 迭代式模型使用了多个连续的光学解码层,这使其能够执行更复杂的、更强的非线性转换。这种多层结构提供了足够的能力,来模拟和再现整个数据分布的复杂性与多样性。
评估指标
- 分布级指标
- IS:衡量可识别性与类间多样性(越高越好)。
- FID:衡量生成分布与真实分布在特征空间的距离(越低越好)。
- 任务级有效性(条件生成)
-
设定多个二分类器(同一 CNN 结构),判断“是否属于指定数字”。
-
三种训练集组成(每类各 5k 正样本 + 5k 负样本,负样本从其余类均匀采样):
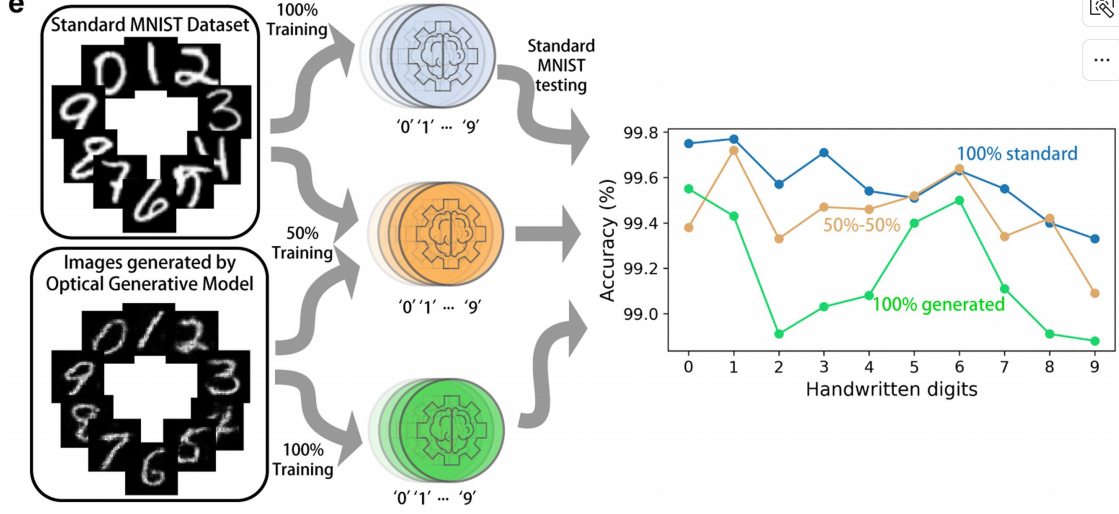
- 标准 MNIST;
- 50% 真实 + 50% 光学生成;
- 纯光学生成。
-
比较分类准确率,检验光学生成样本对下游识别的可用性。
- 数据增强(针对光学生成)
- 用形态学腐蚀/膨胀的随机核生成二值掩膜,模拟手写笔画粗细变化,提升鲁棒性。
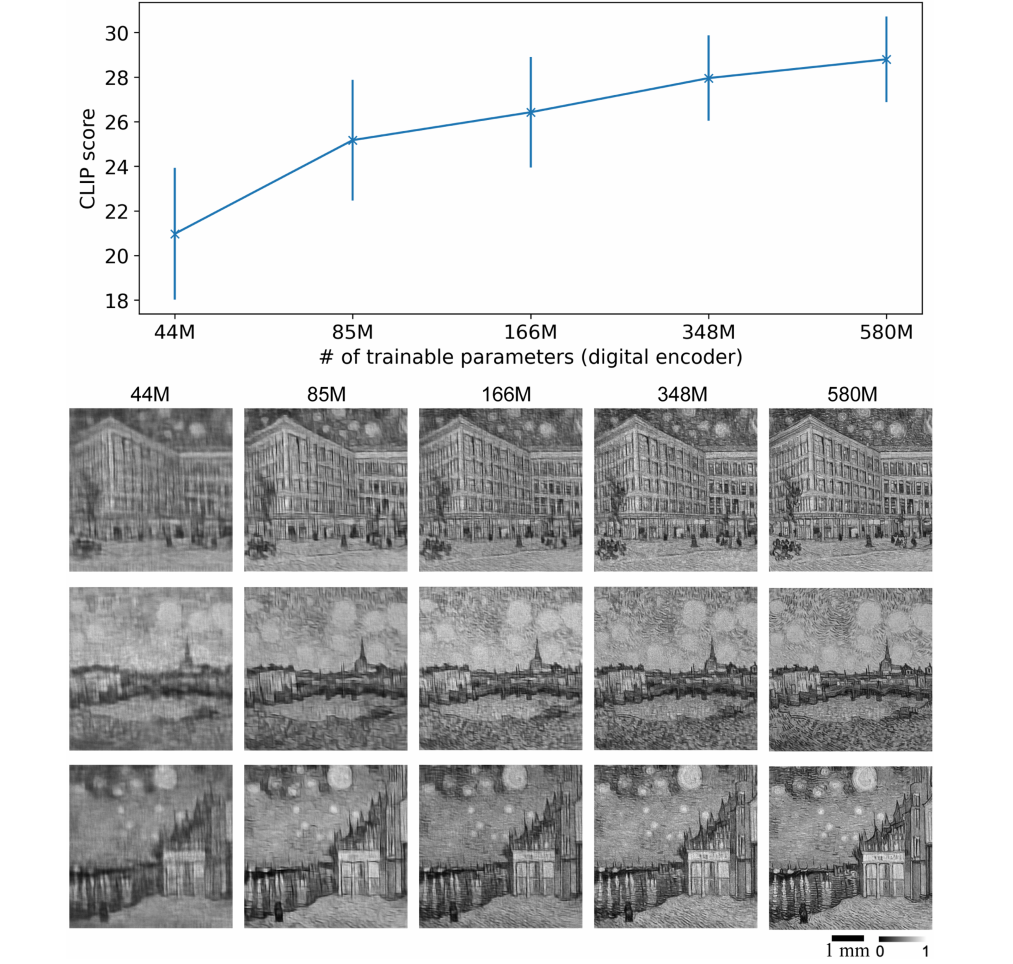
- 高分辨率评估
-
采用 CLIP 分数衡量生成图像与参考文本的语义对齐。
CLIP(Contrastive Language–Image Pre-training 对比式语言–图像预训练)的作用:
- 衡量语义一致性:CLIP 可以计算生成图像和参考文本(如“Van Gogh 风格的建筑”)的相似度,确保光学生成模型不仅生成“像样”的图片,还符合条件语义。
- 补充低层指标:IS/FID 更偏向统计特征;CLIP score 补充了跨模态语义层面的评估。
- 验证泛化能力:光学系统本身受到物理约束,可能生成分布平滑但缺乏语义表达。CLIP 提供了一个更严格的检验标准。
为什么适合高分辨率生成?
- 像素级指标失效
- 在高分辨率艺术图像中,单个像素差异对 FID 有较大影响,但这不等于语义差异。
- 例如,两个 Van Gogh 风格的“向日葵”画,像素统计差很多,但语义上一致。
- FID 会认为它们“不同”,CLIP 会认为它们“相似”。
- 语义层次更丰富
- 高分辨率图像中包含“风格 + 内容 + 细节”多层信息。
- CLIP 的训练目标就是在语义空间对齐,可以捕捉“风格是否像 Van Gogh”,“图像是否包含建筑/植物/人物”。
衍射效率对性能的影响
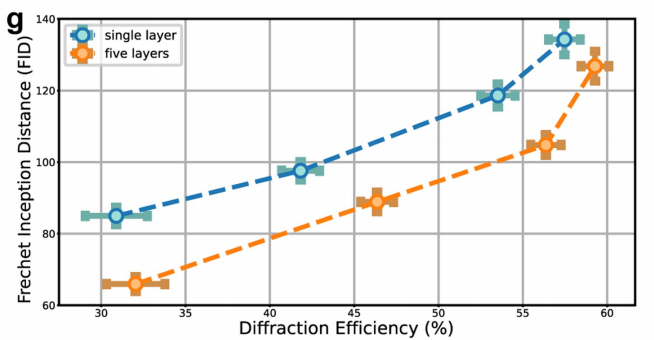
-
衍射效率 定义为图像传感器上分布总光功率与SLM平面上光相位种子总输入功率的比值。
衡量有多少光被有效利用并传输到图像传感器上。更高的η意味着更多的光被引导到期望的图像区域,从而减少光能的损失。这通常通过优化光学元件(如衍射层)的结构来实现,目的是最大化特定方向(即生成图像的方向)的光通量。
-
为什么提高 会使FID提高
- 约束模型自由度: 优化衍射效率本质上是在训练过程中给模型增加了一个额外的约束。为了将更多的光引导到图像传感器上,光学模型可能需要牺牲一些对光场更精细的控制能力。这种为了提高效率而进行的“粗暴”优化,会限制模型生成复杂、高保真图像的能力。
- 损失信息: 光学系统通过衍射来处理信息。当追求极高的衍射效率时,模型可能会倾向于将所有光能集中到生成图像的主体上,这可能导致一些细节信息(如纹理、背景、细微的颜色变化)在衍射过程中丢失。这些丢失的细节信息会导致生成的图像与真实数据集的分布产生偏差,从而使FID增大。
- 牺牲复杂性:
- 低η:模型可以将部分光能分散到多个衍射级,或者以更复杂的方式进行光场调制,以实现更精细的图像生成,尽管这会损失一部分总光能。
- 高η:模型为了最大化单个方向的光能,可能采用更简单的衍射模式,这限制了其对光场进行复杂调控的能力,从而无法生成逼真的、多样化的图像,导致FID升高。
-
对于特定图像质量指标而言,相较于单层光学解码器,采用更深的解码器架构可获得更高的输出衍射效率
彩色光学生成模型
- 三个通道()的随机高斯噪声输入到一个数字编码器
- 把每个波长通道下的相位编码生成种子()按顺序在同一个输入 SLM 上加载
- 在相应波长依次照明下,经由为同一生成任务而联合优化的固定衍射解码器,生成符合目标数据分布的多彩色图像
- 最终图像仍由与之前相同的图像传感器记录。
相位编码对比振幅/强度编码
相位编码的本质优势
- 相位调制改变的是光波的传播路径与干涉模式,带来高度非线性的信息表达。这种非线性增强了解码层的能力,使其能生成更复杂的图像模式。
振幅/强度编码的局限
- 振幅或强度调制本质上是线性叠加:输入的不同模式在输出上只是简单叠加 → 表达力不足;
- 生成的图像往往模糊、缺乏细节或一致性,难以满足复杂任务(如 Van Gogh 风格生成)。
实验对比结果
- 手写数字任务:相位编码 → 更低 FID,说明生成结果更逼真;
- Van Gogh 风格任务:只有相位编码能生成稳定、高质量、高分辨率的结果。
结论
- 相位编码是光学生成模型的核心机制;
- 它提供了强大的非线性表达能力,使浅层数字编码器 + 光学解码器能够胜任复杂图像生成;
- 振幅/强度编码不足以支撑高分辨率和高语义任务。
两个模型对比
特征 快照式光学生成模型 迭代式光学生成模型 核心思路 一次前向传播(数字编码器 + 衍射解码器)直接输出结果 模拟标准扩散模型,逐步去噪迭代,最终得到清晰图像 训练来源 借助大型教师模型(如 DDPM)蒸馏 → 学习更稳定 直接在真实数据分布 上训练 损失函数 学习教师模型的输出分布(知识蒸馏) 基于扩散框架的 MSE,预测 或噪声成分 难度 学习难度大:把整个逆过程压缩成“一步” 每一步只学“轻微去噪”,学习难度相对低 优点 推理快(单快照即可),硬件友好 训练不依赖教师模型,更接近标准扩散训练方式 缺点 训练依赖教师模型,模型本身表达力有限 推理慢,需要迭代 次(一般上百步到千步) 应用场景 更适合强调实时/快速生成 更适合强调高保真生成,追求接近标准扩散效果
实验设备
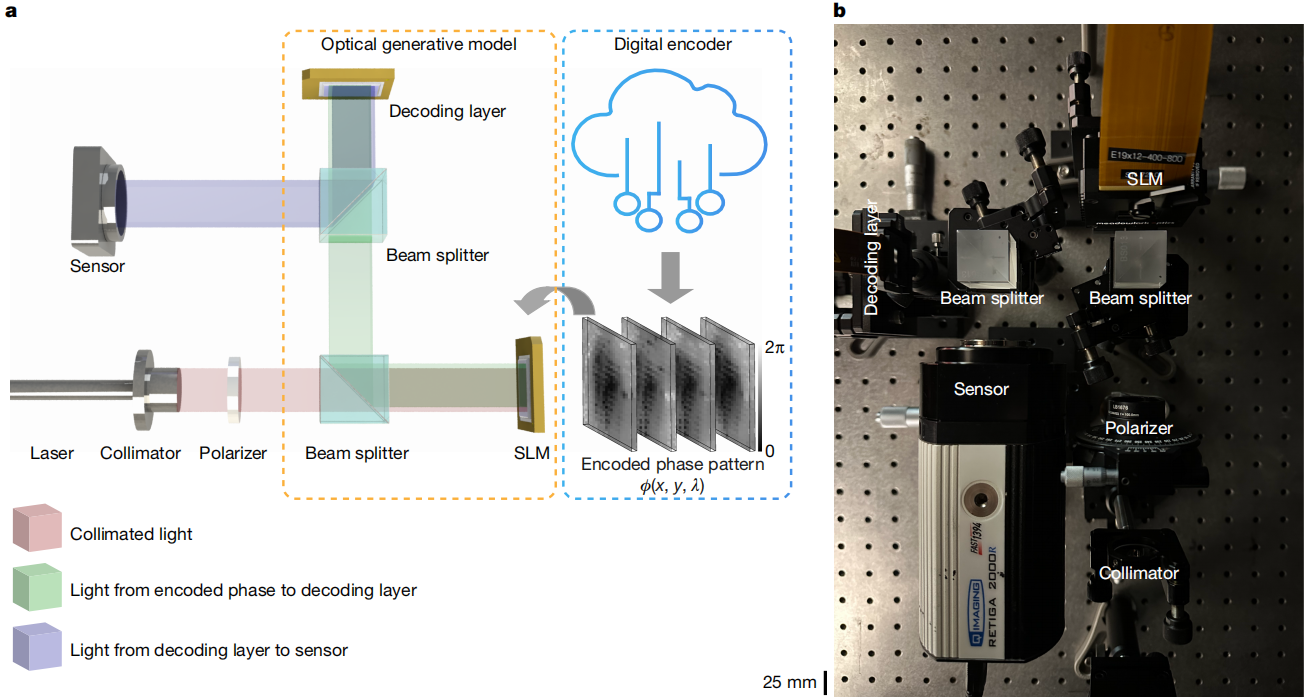
实验设备:
模块 设备 / 型号 关键规格 作用 光源 Fianium 激光器 波长 520 nm(单色实验),{450, 520, 638} nm(多通道彩色) 提供相干光照明 空间滤波 4f 系统 + 小孔 傅里叶面针孔 0.1 mm 滤除高频噪声,得到干净平面波 SLM1(编码) Meadowlark XY Phase Series 像素间距 8 μm;分辨率 1920×1200 加载编码相位 SLM2(解码) HOLOEYE PLUTO-2.1 像素间距 8 μm;分辨率 1920×1080 加载优化解码相位 成像传感器 QImaging Retiga-2000R 像素间距 7.4 μm;分辨率 1600×1200 采集输出光强 参数配置:
实验场景 编码相位分辨率 解码层分辨率 传感器分辨率 光路距离 特殊处理 MNIST / Fashion-MNIST 320×320 400×400 320×320 mm; mm 中心裁剪、归一化、缩放 Van Gogh 单色生成 1000×1000 1000×1000 640×640 同上 分辨率提升 多通道彩色生成 同上 同上 同上 同上 RGB 波长 {450, 520, 638} nm 依次照明;Gamma 校正
潜空间的插值实验
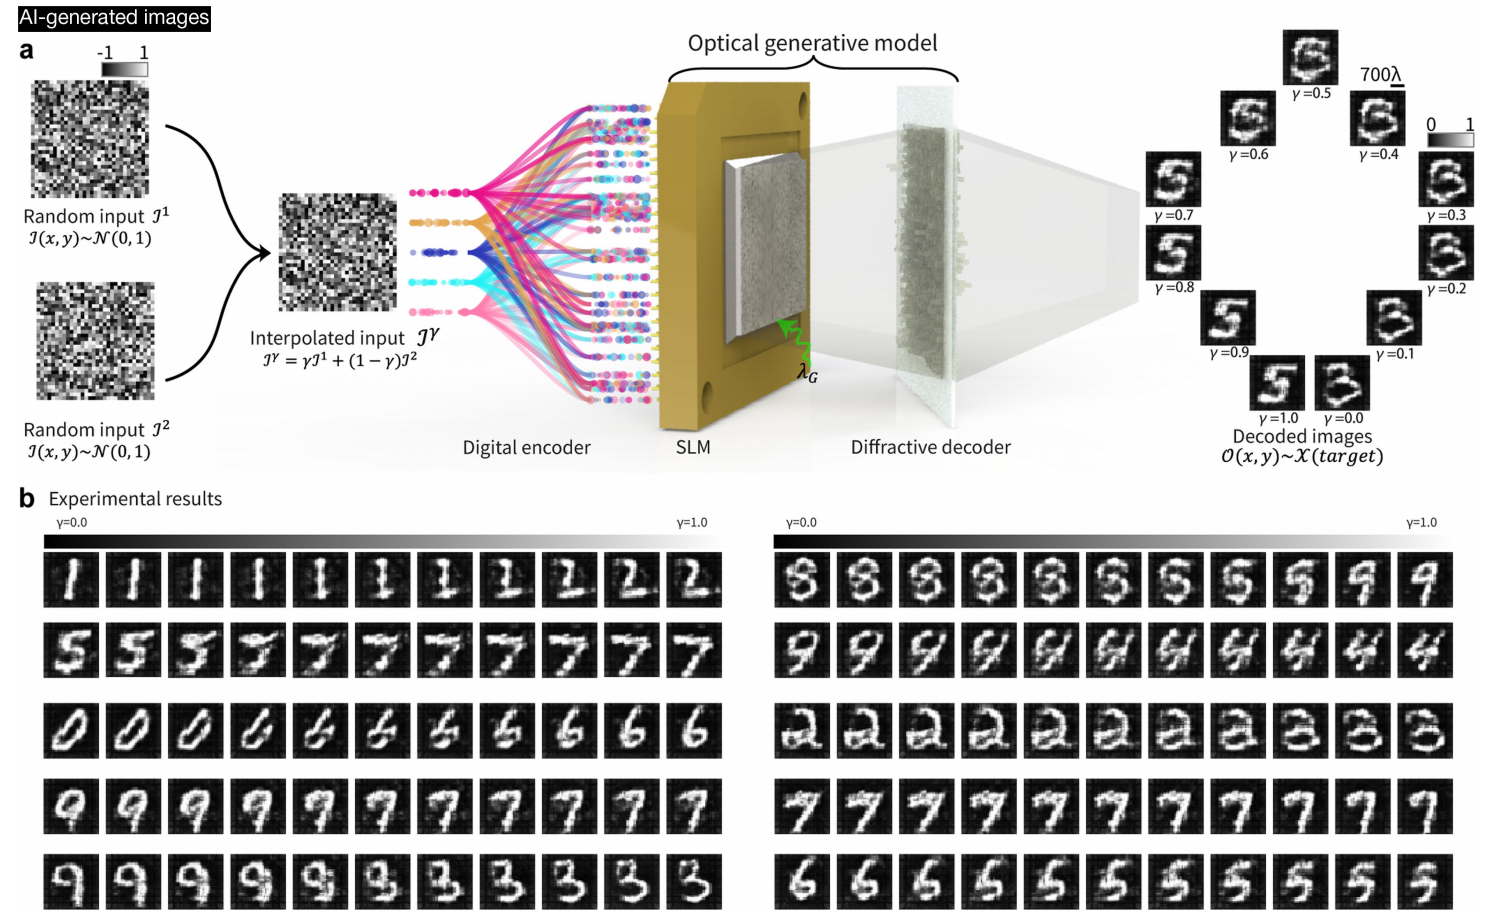
为了探索快照式光学生成模型的潜在空间,作者设计了插值实验,考察随机噪声输入与生成图像之间的关系。
- 具体做法:从正态分布 中采样两个随机输入 和 ,并按
在它们之间进行线性插值()。类别嵌入向量也采用同样的方式插值。
实验结果(手写数字):
- 插值生成的图像在 到 的过程中表现为平滑过渡,说明模型的潜空间是连续且有组织的。
- 当类别嵌入也插值时,生成结果能够在不同数字之间平滑转换,而且过程中一直保持“数字般的可识别特征”。
- 这表明该光学生成模型不仅能重建单一类别,还能实现外延泛化,有效捕捉手写数字的整体数据分布。
隐私保护和多路复用
一张编码相位(同一数字编码器输出)+ 多个物理解码器(衍射解码器)。
通过不同波长(和/或偏振)**依次照明,同一相位在各通道上被“各自匹配”的衍射解码器**专属还原出不同的图像。
形成 多路复用 + 隐私保护:没有对应的物理解码器,别人看不到有用内容
与数字生成模型作能耗比较
场景 模型形态 光学传播次数 主要能耗构成 典型能耗(每图像) 总体结论 低分辨率任务(MNIST / Fashion-MNIST) 快照式光学 1 编码器≈0.003–0.033 mJ;输入 SLM≈30–58 mJ(可降至 <2.5 mJ);相机≈2–4 mJ;传播≈0 ≈30–60 mJ(用商用液晶 SLM)≈<10 mJ(用低功耗 SLM/被动器件) 与数字相近或更低;更换低功耗/被动器件后优势更明显 低分辨率任务(MNIST / Fashion-MNIST) 迭代式光学 5–10 单步≈快照式;乘以步数 ≈0.15–0.6 J(取 5–10 步、商用 SLM) 比快照式高,但步数仍远少于数字扩散 低分辨率任务(MNIST / Fashion-MNIST) 数字 DDPM 1000± 纯计算(数百 GFLOPs) ≈0.14–1.58 J 与迭代式接近;快照式更省 高分辨率任务(Van Gogh 风格) 快照式光学 1 编码器主导≈0.13–12 J;输入 SLM≈30–58 mJ;相机若需 ≈0.28–30 J(随任务复杂度而变) 显著低于数字扩散(1–3 个数量级) 高分辨率任务(Van Gogh 风格) 迭代式光学 5–10 单步开销 × 步数 ≈1–60 J(粗略量级) 仍显著低于数字扩散 高分辨率任务(Van Gogh 风格) 数字 DDPM 1000± 纯计算(数百 TFLOPs) ≈265–2916 J 能耗最高、延迟大 展望:
被动化解码器(DOE/纳米相位面)
- 将训练好的解码相位固化为被动元件,解码端功耗≈0,只需照明即可工作;适合端侧/可穿戴/近眼显示(HMD、眼镜)。
- 代价:不可调,任务专用;但可批量制造、成本低。
低功耗 SLM 与器件替代
- 新一代 SLM 单帧能耗可 <2.5 mJ/图;
- 某些场景直接用被动 DOE 替代 SLM,进一步降低能耗与复杂度。
更高效的“扩散替代”与步数压缩
- 采用隐式/加速扩散推理(步数从 1000 减至个位/十位),在 迭代式光学 中进一步降低总能耗与时延。
端侧直显,绕开数模/模数链路
- 若输出直接在光学域显示(而非采集-数字化-再显示),可避免 ADC/DAC 与显示链路能耗,进一步降低系统总能耗。
多路复用与隐私保护
- 通过波长/偏振通道 + 专属衍射解码器,实现“一图多解、各取所需”的私有多路复用;这在公共场景的安全可视通信、防伪与个性化访问控制中具有独特价值。