
Pi Research
让研究方向,在持续阅读中生长。
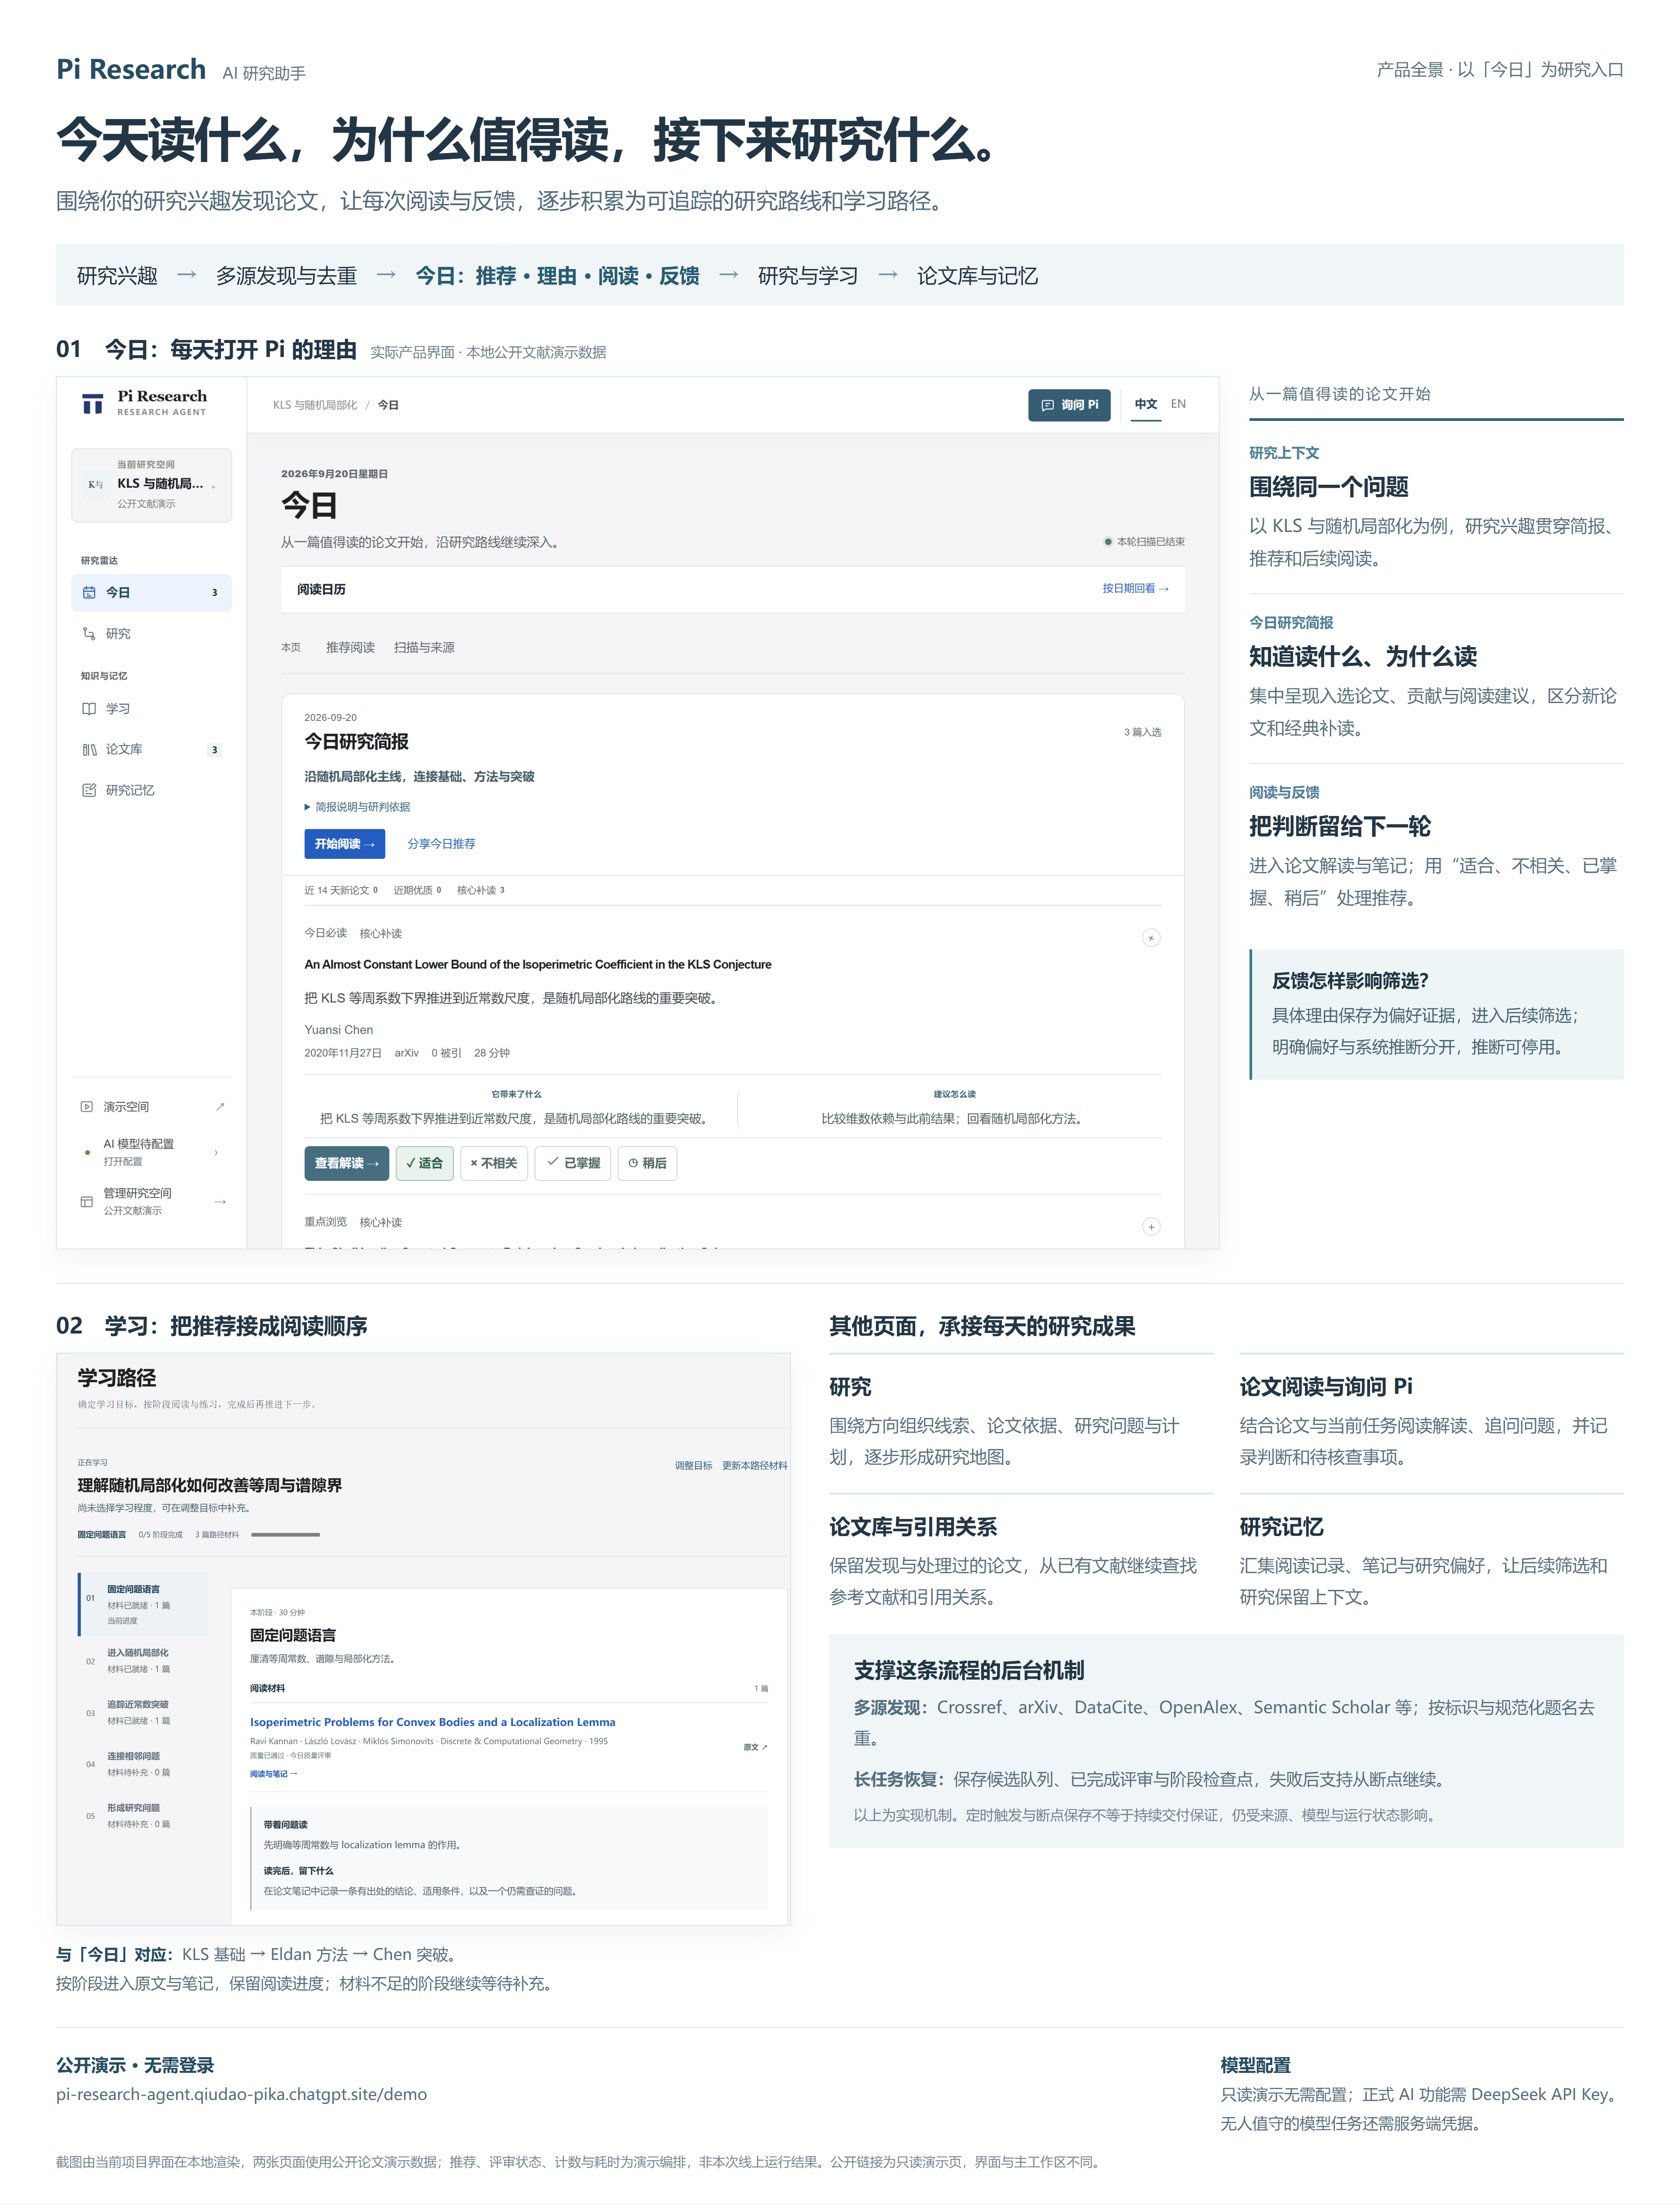
持续发现相关论文,结合阅读反馈,整理研究地图与个性化学习路径。
- 设定研究方向
- 筛选相关论文
- 积累阅读反馈
- 生长研究地图
为什么做这个项目
研究一个方向时,困难往往不是找到一篇论文,而是持续判断:哪些新工作值得读,它们和已有知识有什么关系,下一步该补上哪一块基础。Pi Research 把论文发现和后续阅读放在同一个持续积累的研究空间里。
核心功能
- 持续发现论文:结合多个学术数据源,覆盖近期进展与较长时间跨度的相关工作,记录已经探索过的来源和查询。
- 结合反馈筛选:根据研究方向与用户的接受、暂缓或排除反馈,给出论文简介和阅读理由。
- 整理研究地图:将积累的论文组织成方向与关联,让阅读不止停留在一张收藏清单。
- 生成学习路径:根据真实论文和已有研究上下文,帮助安排后续阅读。
怎么开始
- 打开仓库中的使用说明,按当前要求配置并启动项目。
- 建立研究空间,明确希望探索的问题或方向。
- 配置模型服务,阅读推荐论文,并补充接受或排除的理由。
- 随着文献积累,查看方向地图和学习路径,调整下一步阅读。
目前介绍页提供仓库入口;部署和模型配置以仓库说明为准。
技术实现与取舍
项目将学术数据检索、模型筛选和研究状态存储连接起来。检索负责找到候选,模型负责结合研究上下文判断相关性,持久化的研究空间记录文献、反馈与探索进度。
这里尤其关注两个问题:避免每轮从零搜索,以及区分用户明确表达的偏好和系统推断。前者让持续探索可以累积,后者让研究方向仍由用户掌握。推荐适合帮助安排阅读,具体结论仍需回到论文核对。
项目链接
本文根据项目公开说明整理,功能会随开发继续更新。