
Pi_zaya
每一个论文结论,都有证据可循。
围绕本地学术 PDF,连接文献问答、原文定位、证据矩阵与研究简报。
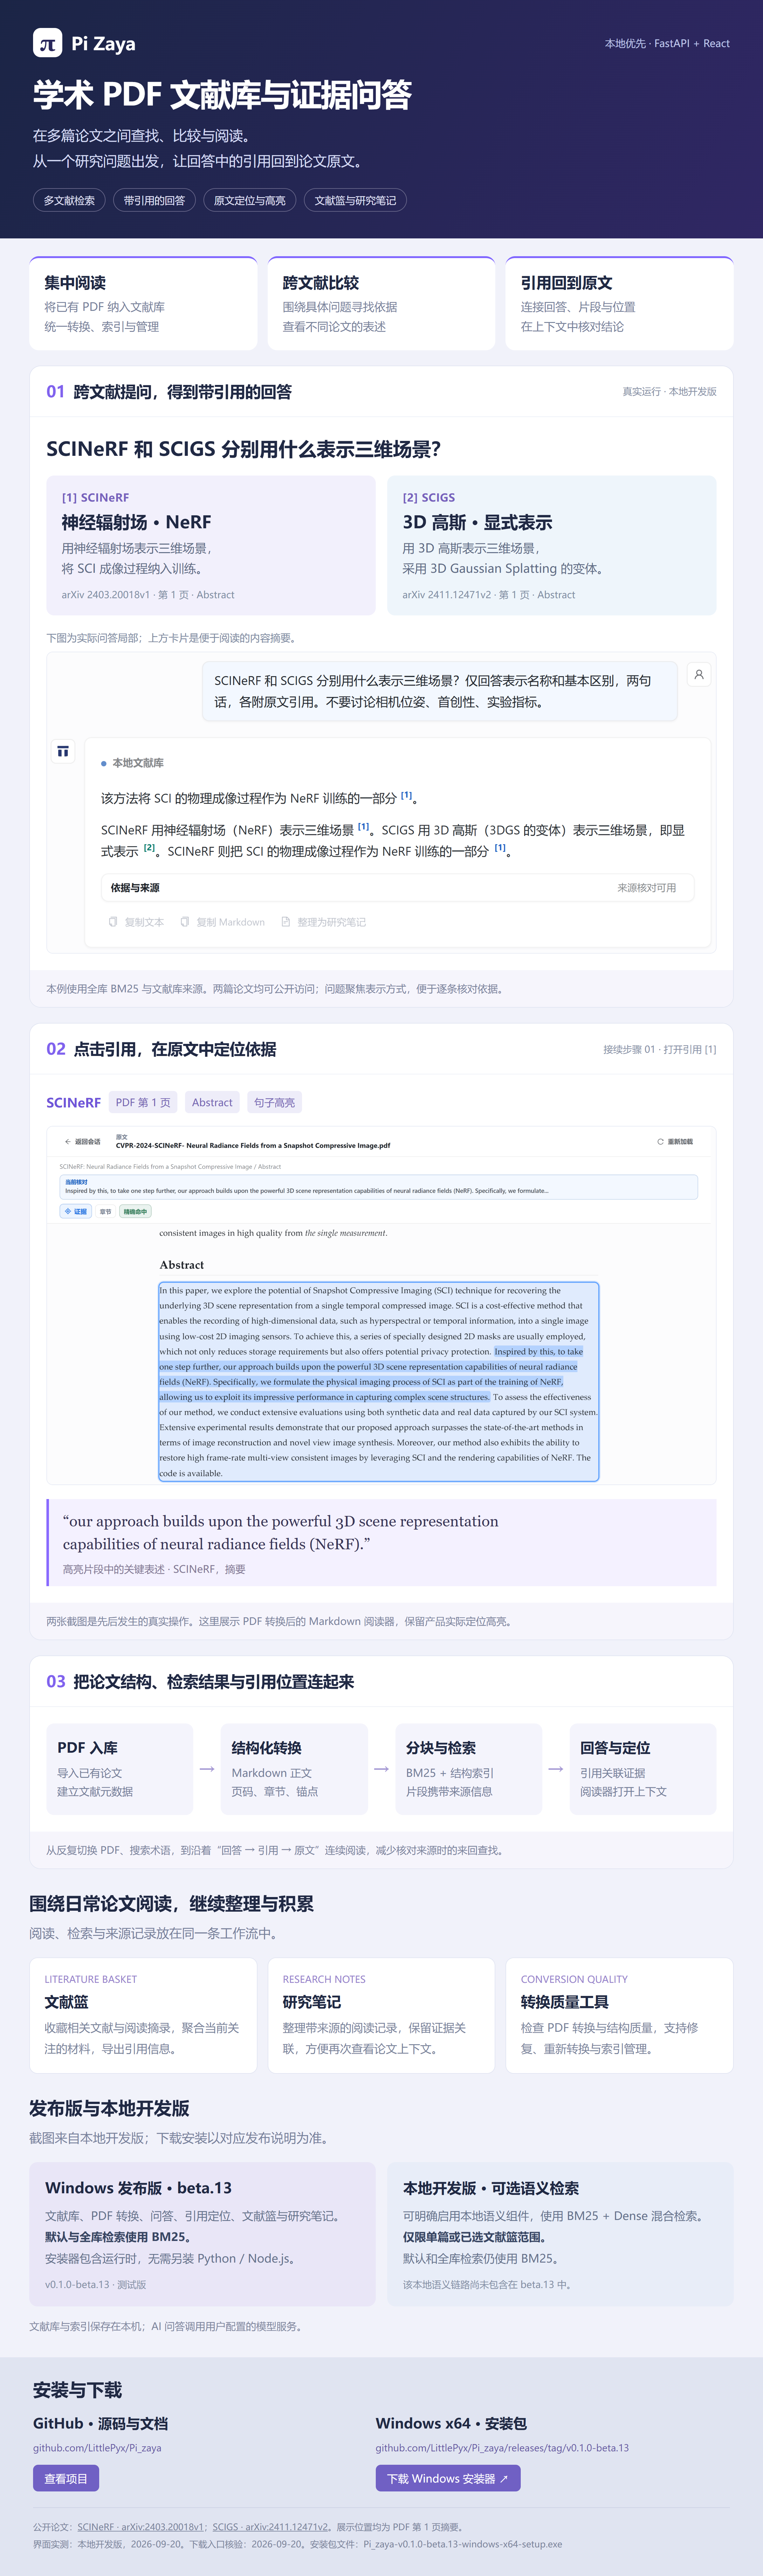
- 导入学术 PDF
- 检索文献证据
- 回到原文核对
- 整理研究结论
为什么做这个项目
论文问答里,一段流畅的回答还不够。更实际的问题是:这句话来自哪篇论文、哪一页?不同论文的实验能不能直接比较?整理出的结论还能不能追溯到原文?Pi_zaya 围绕这些问题,将本地文献阅读与证据整理连接起来。
核心功能
- 文献导入与阅读:把学术 PDF 转换为可检索的内容,同时保留页面和来源线索。
- 带证据的问答:在文献库中检索相关片段,结合回答展示引用,方便回到原文核对。
- 跨论文整理:用证据矩阵组织方法、实验、结果与局限,保留每个事实对应的来源。
- 研究笔记与简报:把阅读中的发现沉淀为笔记,并基于核验后的证据组织研究简报。
怎么开始
- 从 Releases 获取 Windows 测试版,按发布说明完成安装。
- 按项目指南配置所需模型服务,导入想阅读的 PDF。
- 等待转换与索引完成,再提问并检查引用对应的原文。
- 将需要长期保留的证据加入笔记或矩阵,逐步形成研究材料。
本地优先指文献库与研究资料在本机管理;使用外部模型的能力仍需要对应服务配置,并不等于所有处理都离线完成。当前 Windows 发布属于测试版。
技术实现与取舍
项目采用 FastAPI 与 React 组织后端能力和阅读界面,连接 PDF 转换、结构化索引、混合检索、Agent 工具调用和结论核验。
关键取舍是让回答与证据一起出现。跨论文比较也不能只把数字放在同一张表里,还需要检查任务、数据集、实验设置与指标是否一致。证据不足的部分应保留空缺,来源变更后则需要重新检查相关结论。
开源进展
截至 2026 年 10 月 18 日,GitHub 仓库获得 103 个 Star。
针对论文问答中的条件与证据对应问题,实现了 N2N 条件与已核验原文片段的绑定,并配套测试,让条件说明可以回到具体来源核对。查看相关实现。
该实现已入选 XERJ Corpus Hub(XERJ 官方仓库拥有 17,365 个 Star,截至 2026 年 10 月 29 日),作为 AI 编程 Agent 可检索的代码参考案例。公开收录页面标注作者与项目来源,并提供对应实现的检索入口。查看个人收录页面。
项目链接
本文根据项目公开说明整理;安装方式、版本和能力边界以最新发布说明为准。